Dokumentacja
Konfiguracja serwera
Tłumaczenie to zadanie LLM per funkcja, konfigurowane raz na serwerze. Każde żądanie tłumaczenia od dowolnego klienta — wiadomości czatu, szkice commitów, zaznaczenia edytora i diffów — przechodzi przez te same ustawienia.
Włączenie funkcji
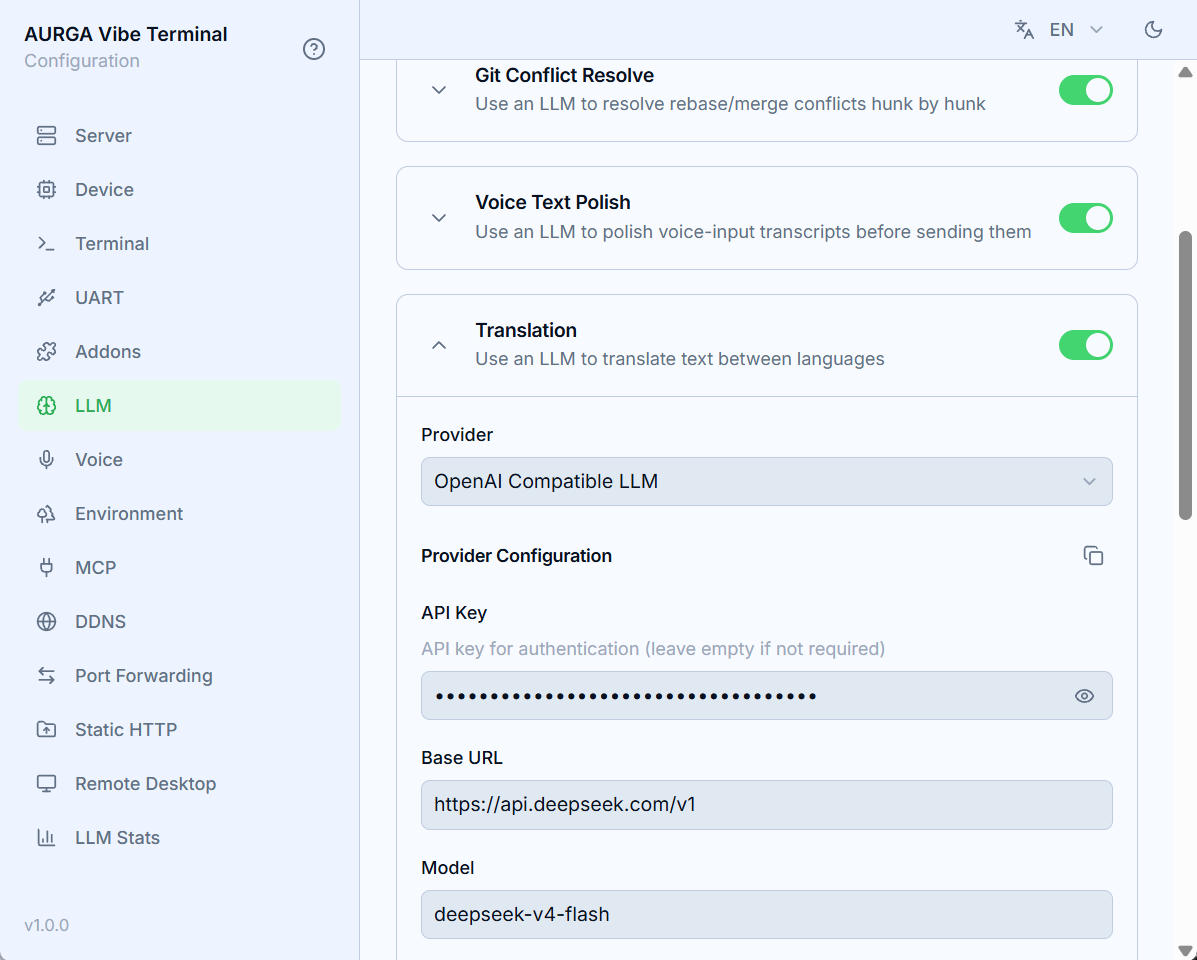
Otwórz sekcję LLM interfejsu WWW i znajdź kartę Tłumaczenie:
- Włącz
Włącz tłumaczenie LLM; - Wybierz
Dostawca— lista rozwijana pokazuje addony LLM włączone w sekcjiDodatki(wbudowany provider OpenAI Compatible LLM pokrywa większość przypadków); - Wypełnij pola providera pod
Konfiguracja dostawcy(dla wbudowanego:Base URL,API Key,Model, opcjonalnieExtra Body, limity tokenów,Timeout); - Wybierz
Język docelowy, w którym powstanie każde tłumaczenie.
Konfiguracja zapisuje się nawet przy wyłączonej funkcji, ale serwer stosuje ją dopiero po włączeniu przełącznika. Bez niego żądania klienta kończą się błędem “translation addon is not configured or disabled”.
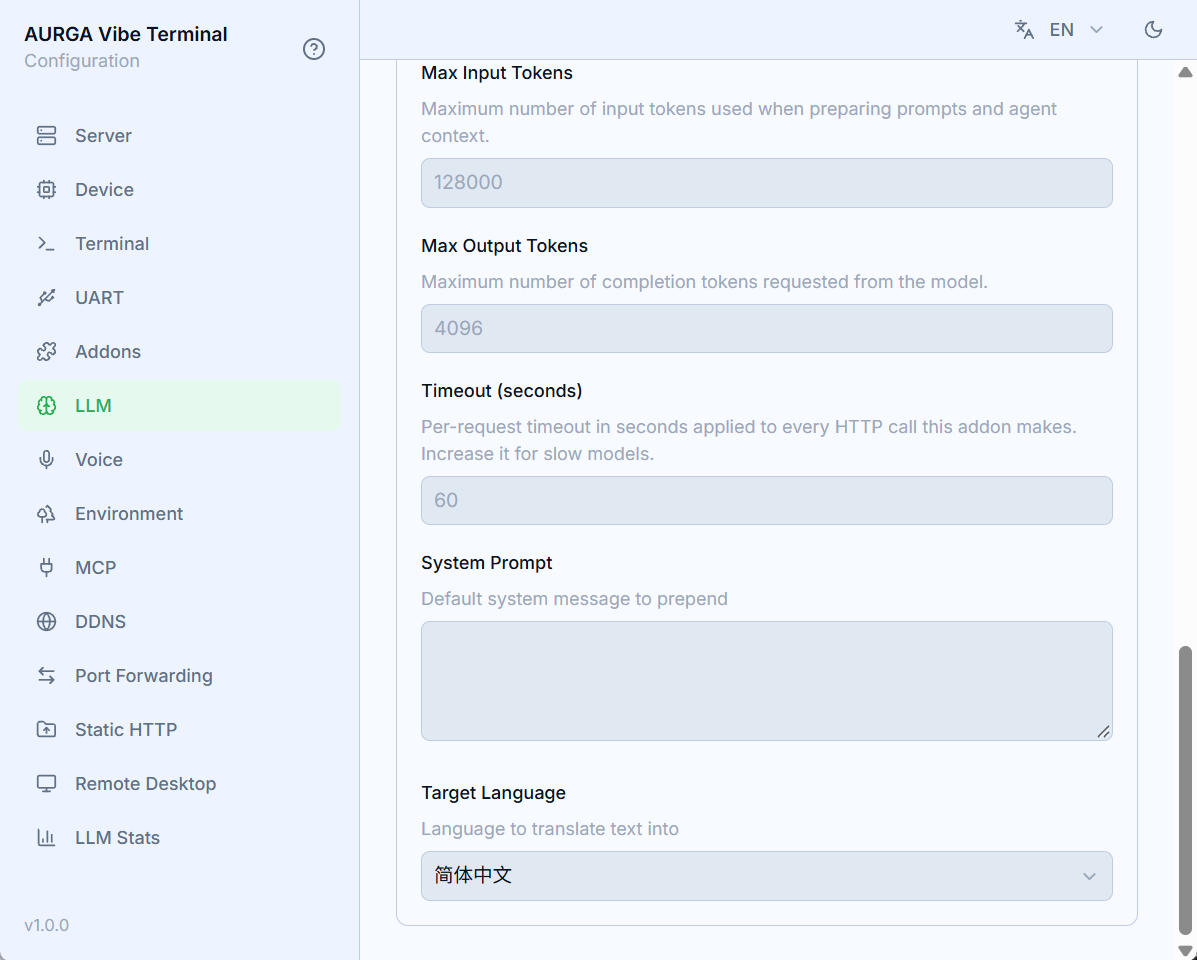
Język docelowy
W przeciwieństwie do funkcji terminala i Gita tłumaczenie nie ma opcji Automatycznie — zawsze tłumaczy na jeden jawny język z listy (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). Ustawienie działa dla całego serwera; zmiana wpływa tylko na nowe żądania. Nieustawiony język wraca do angielskiego.
Ponowne użycie danych providera
Przyciski kopiuj/wklej obok nagłówka Konfiguracja dostawcy klonują wartości pól między kartami funkcji korzystającymi z tego samego addonu providera — wybierz i wypełnij providera raz (np. dla komunikatów commitów Gita), naciśnij Kopiuj, a potem Wklej w karcie Tłumaczenie.
Wybór modelu
Tłumaczenia to krótkie, wrażliwe na opóźnienia prompty — szybki model wygrywa z dużym modelem rozumującym. Qwen3.5 9B za endpointem zgodnym z OpenAI (Ollama, vLLM, llama.cpp) albo DeepSeek V4 Flash przez API sprawdzają się świetnie. Serwer czeka do 60 sekund na żądanie; wolnym lokalnym modelom może być potrzebny wyższy Timeout w polach providera.
Tryb myślenia dodaje sekundy opóźnienia bez zysku jakości — wyłącz go w
Extra Body, np.{"enable_thinking": false}dla Qwen albo{"thinking": {"type": "disabled"}}dla DeepSeek.