Documentação
Configuração do servidor
A tradução é um trabalho LLM por recurso, configurado uma vez no servidor. Toda solicitação de tradução de qualquer cliente — mensagens de chat, rascunhos de commit, seleções do editor e de diffs — passa pelas mesmas configurações.
Habilitar o recurso
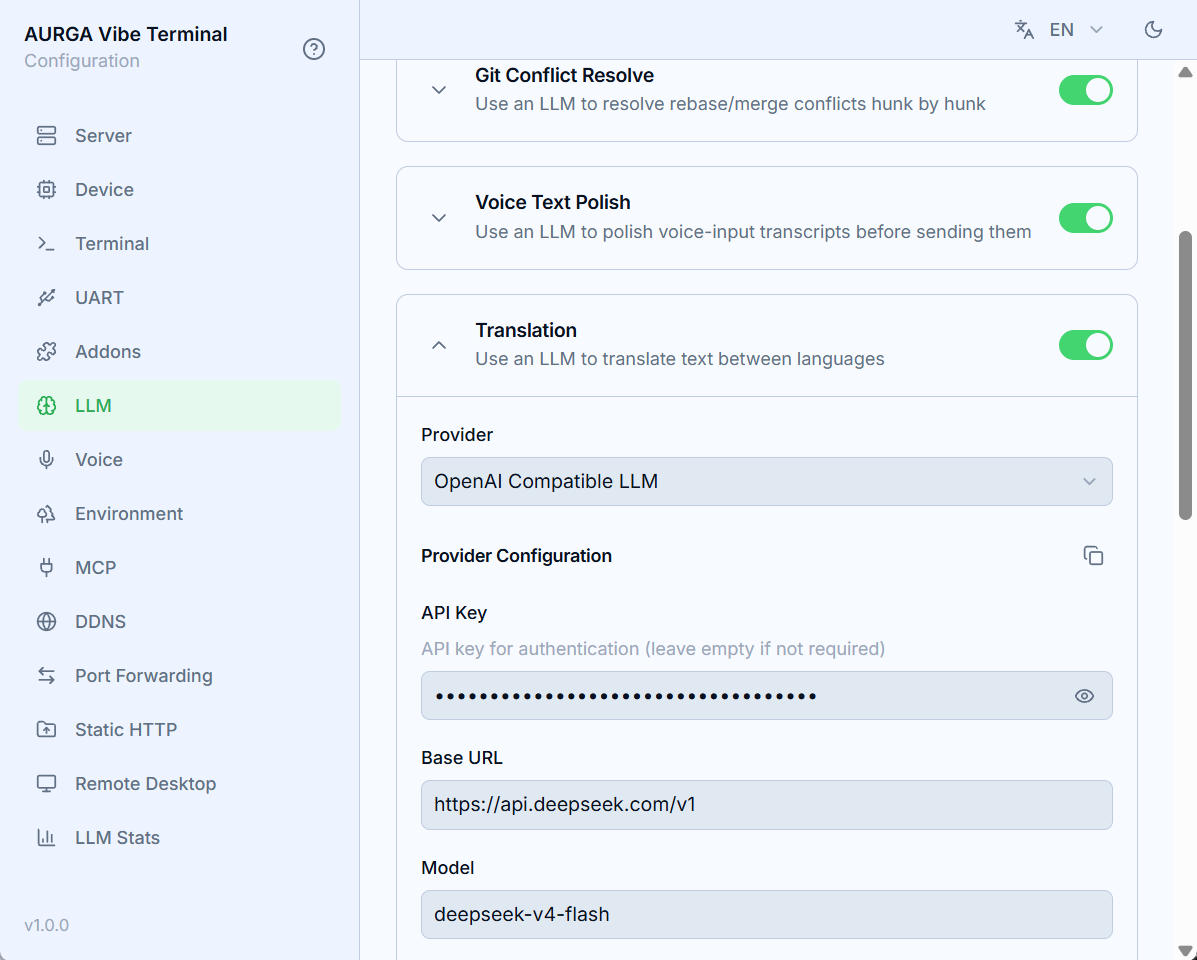
Abra a seção LLM da interface Web e localize o cartão Tradução:
- Ative
Ativar tradução por LLM; - Escolha um
Provedor— o dropdown lista addons LLM que estão habilitados na seçãoComplementos(o provedor integrado OpenAI Compatible LLM cobre a maioria dos casos); - Preencha os campos do provedor sob
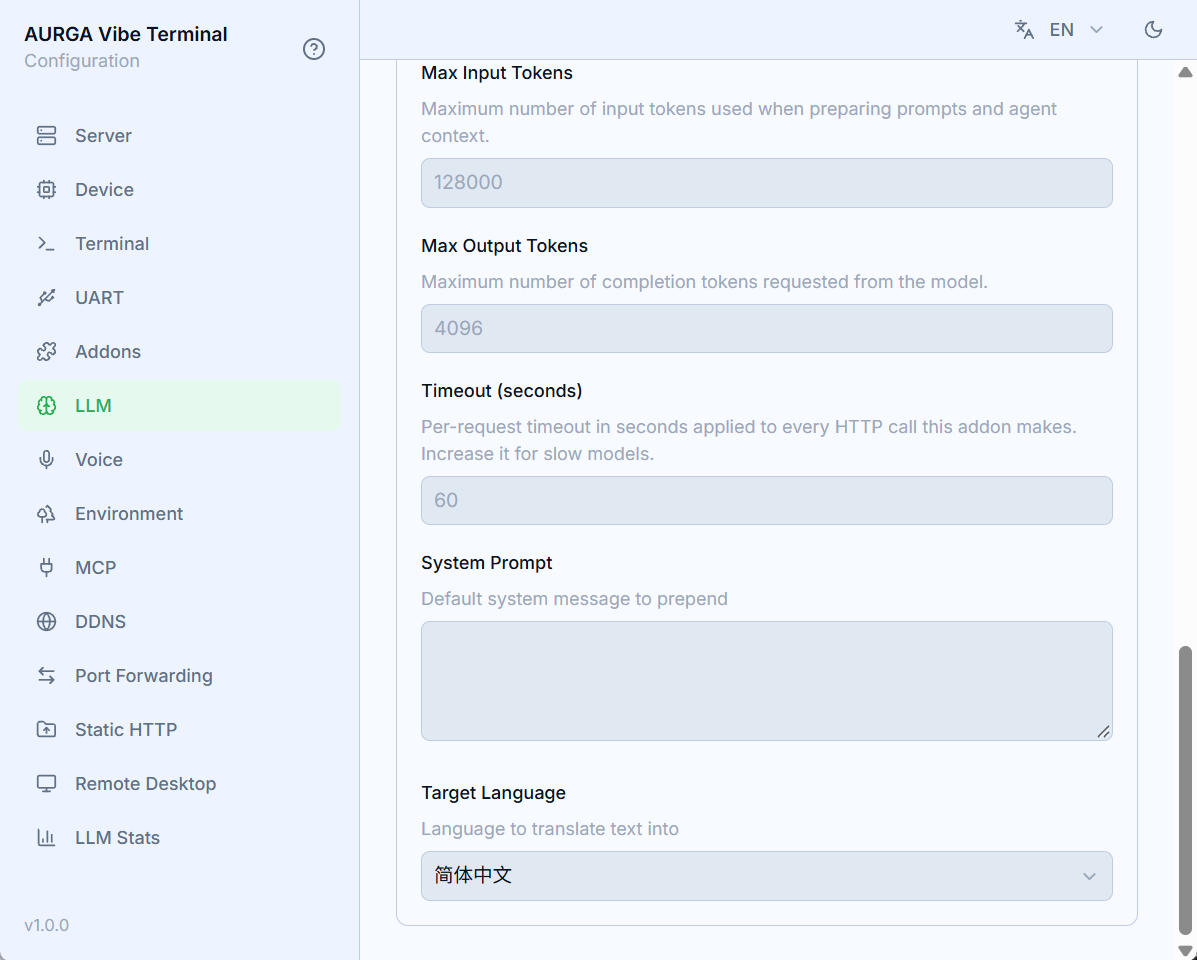
Configuração do provedor(para o integrado:Base URL,API Key,Modele opcionalmenteExtra Body, limites de tokens,Timeout); - Escolha o
Idioma de destinoem que cada tradução será escrita.
A configuração é salva mesmo com o recurso desabilitado, mas o servidor só a aplica quando a chave está ligada. Sem ela, as solicitações do cliente falham com “translation addon is not configured or disabled”.
Idioma de destino
Diferente dos recursos de terminal e Git, a tradução não tem opção Automático — ela sempre traduz para um idioma explícito da lista (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). A configuração vale para todo o servidor; trocá-la afeta apenas novas solicitações. Um idioma não definido volta para o inglês.
Reutilizar credenciais do provedor
Os botões copiar/colar ao lado do título Configuração do provedor clonam valores de campos entre cartões de recurso que usam o mesmo addon de provedor — escolha e preencha o provedor uma vez (por exemplo, para mensagens de commit do Git), pressione Copiar e depois Colar no cartão Tradução.
Escolher modelo
Traduções são prompts curtos e sensíveis a latência — um modelo rápido vence um modelo grande de raciocínio. Qwen3.5 9B atrás de um endpoint compatível com OpenAI (Ollama, vLLM, llama.cpp) ou DeepSeek V4 Flash via API funcionam bem. O servidor espera até 60 segundos por solicitação; modelos locais lentos podem precisar de um Timeout maior nos campos do provedor.
O modo de raciocínio adiciona segundos de latência sem ganho de qualidade aqui — desative-o no
Extra Body, p. ex.{"enable_thinking": false}para Qwen ou{"thinking": {"type": "disabled"}}para DeepSeek.