Documentación
Configuración del servidor
La traducción es una tarea LLM por función que se configura una vez en el servidor. Cada petición de traducción de cualquier cliente — mensajes de chat, borradores de commit, selecciones del editor y de diffs — pasa por los mismos ajustes.
Habilitar la función
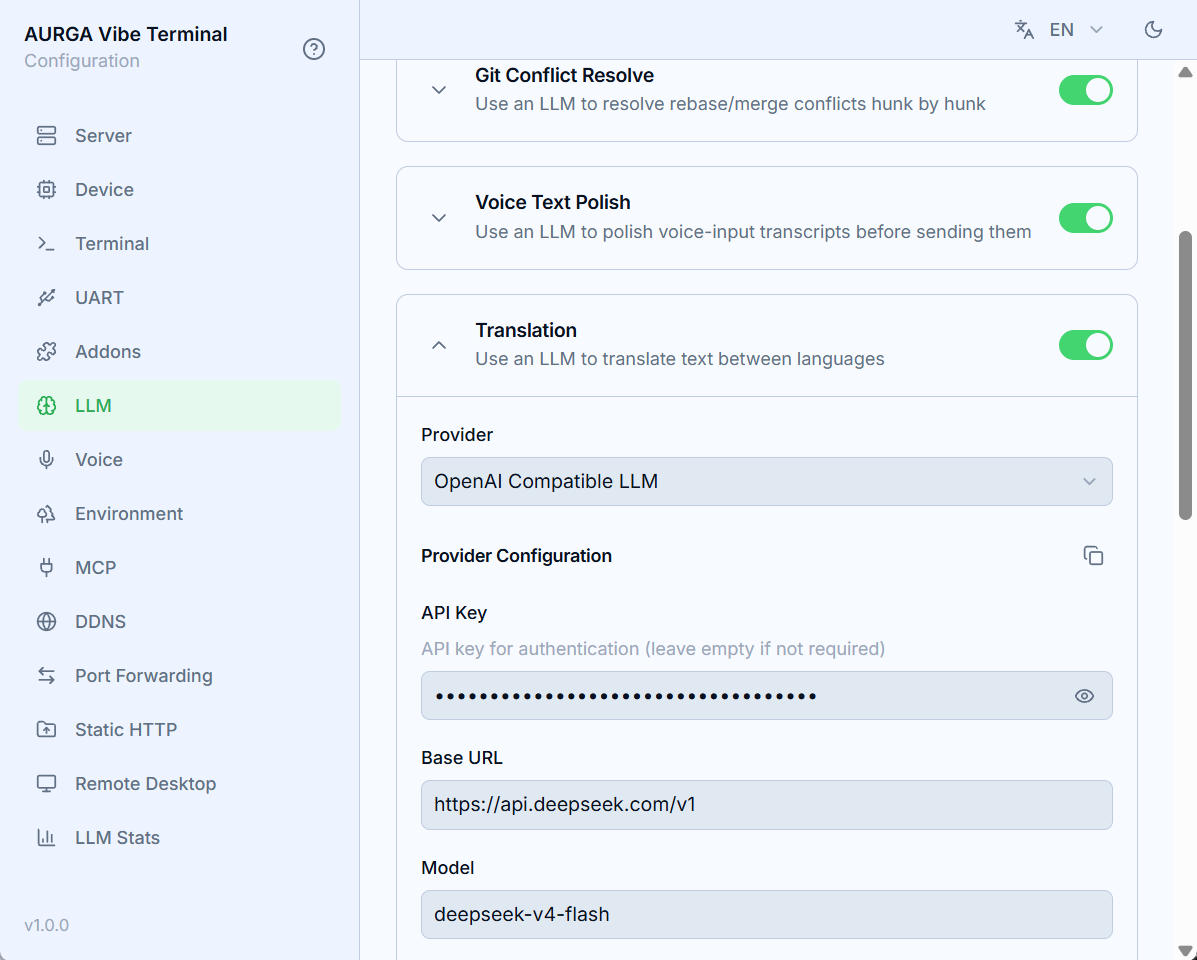
Abre la sección LLM de la interfaz web y busca la tarjeta Traducción:
- Activa
Activar la traducción con LLM; - Elige un
Proveedor— el desplegable lista los addons LLM que están habilitados en la secciónComplementos(el proveedor integrado OpenAI Compatible LLM cubre la mayoría de los casos); - Rellena los campos del proveedor bajo
Configuración del proveedor(para el integrado:Base URL,API Key,Modely opcionalmenteExtra Body, límites de tokens,Timeout); - Elige el
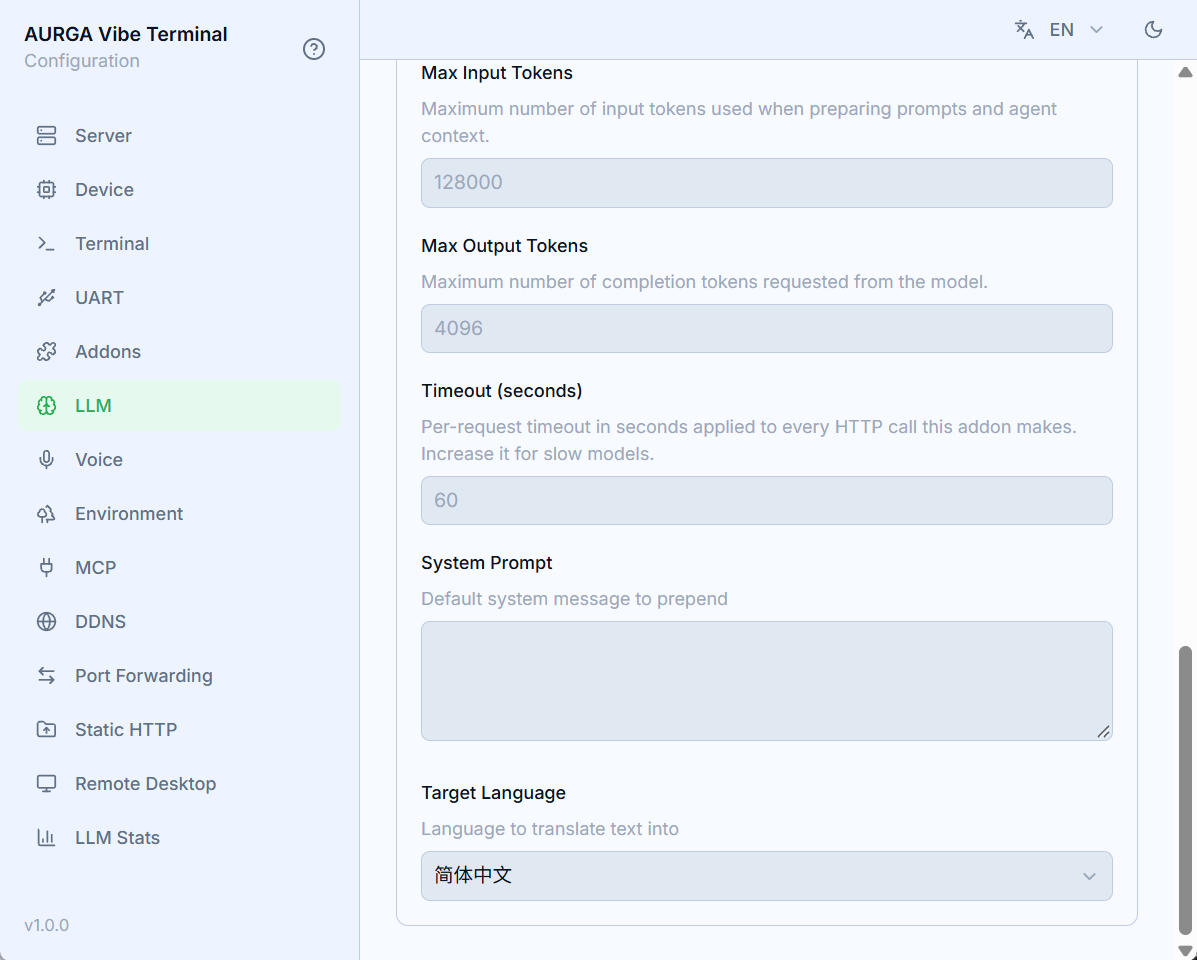
Idioma de destinoen el que se escribirá cada traducción.
La configuración se guarda incluso con la función deshabilitada, pero el servidor solo la aplica cuando el interruptor está encendido. Sin él, las peticiones del cliente fallan con “translation addon is not configured or disabled”.
Idioma de destino
A diferencia de las funciones de terminal y Git, la traducción no tiene opción Automático — siempre traduce a un idioma explícito de la lista (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). El ajuste se aplica a todo el servidor; cambiarlo solo afecta a las peticiones nuevas. Un idioma sin configurar vuelve al inglés.
Reutilizar las credenciales del proveedor
Los botones de copiar/pegar junto al encabezado Configuración del proveedor clonan los valores de campos entre tarjetas de función que usan el mismo addon de proveedor — elige y rellena el proveedor una vez (por ejemplo, para mensajes de commit de Git), pulsa Copiar y luego Pegar en la tarjeta Traducción.
Elegir modelo
Las traducciones son prompts cortos y sensibles a la latencia — un modelo rápido vence a uno grande de razonamiento. Qwen3.5 9B tras un endpoint compatible con OpenAI (Ollama, vLLM, llama.cpp) o DeepSeek V4 Flash por API funcionan bien. El servidor permite hasta 60 segundos por petición; los modelos locales lentos pueden necesitar un Timeout mayor en los campos del proveedor.
El modo de pensamiento añade segundos de latencia sin ganancia de calidad aquí — desactívalo en
Extra Body, p. ej.{"enable_thinking": false}para Qwen o{"thinking": {"type": "disabled"}}para DeepSeek.