Dokumentation
Server-Setup
Übersetzung ist ein funktionsbezogener LLM-Job, der einmal auf dem Server konfiguriert wird. Jede Übersetzungsanfrage von beliebigen Clients — Chat-Nachrichten, Commit-Entwürfe, Editor- und Diff-Auswahlen — läuft über dieselben Einstellungen.
Funktion aktivieren
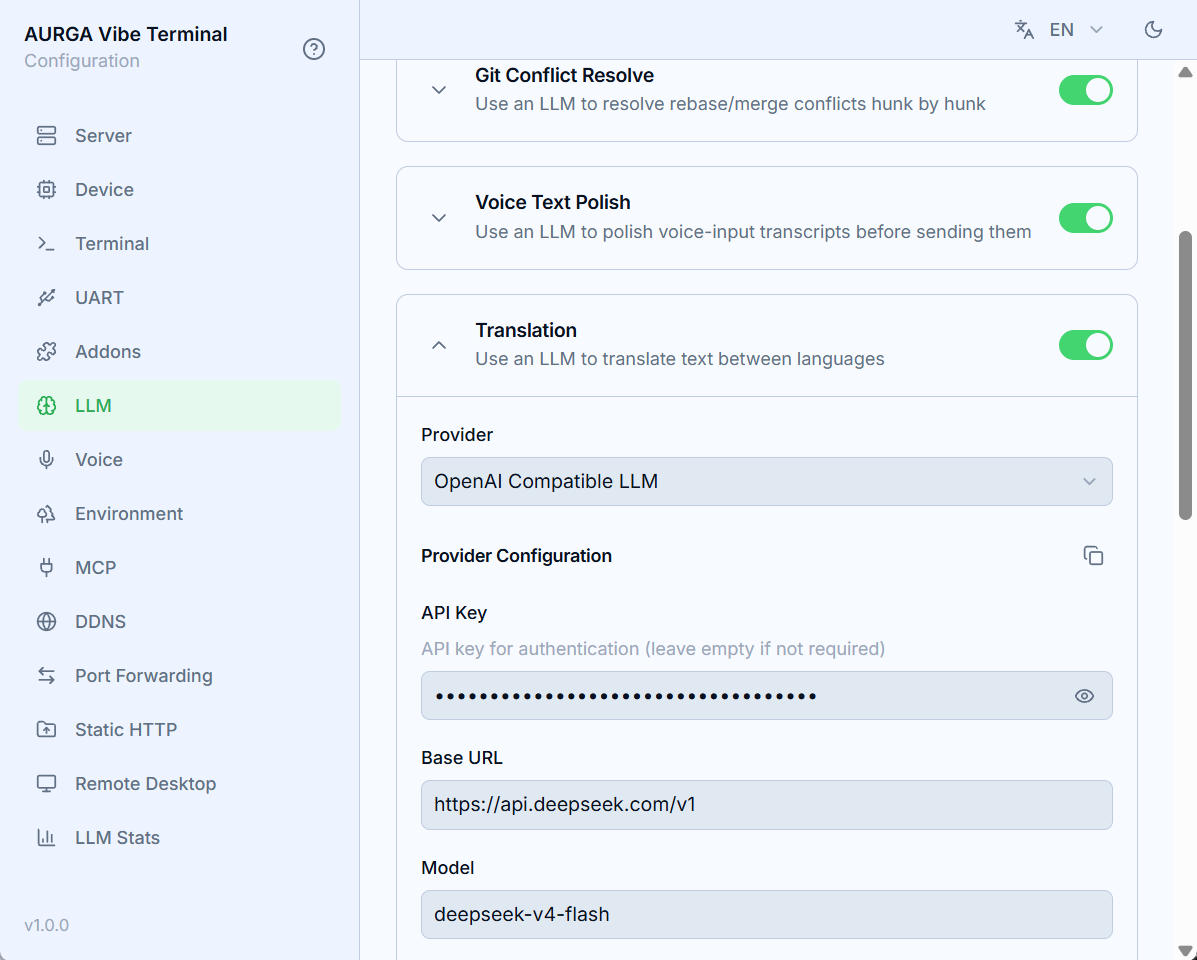
Öffnen Sie den Abschnitt LLM der Web UI und suchen Sie die Karte Übersetzung:
- Schalten Sie
LLM-Übersetzung aktivierenein; - Wählen Sie einen
Anbieter— die Dropdown-Liste führt LLM-Addons, die im AbschnittAddonsaktiviert sind (der eingebaute Provider OpenAI Compatible LLM deckt die meisten Fälle ab); - Füllen Sie die Felder unter
Anbieterkonfigurationaus (beim eingebauten Provider:Base URL,API Key,Modelsowie optionalExtra Body, Token-Limits,Timeout); - Wählen Sie die
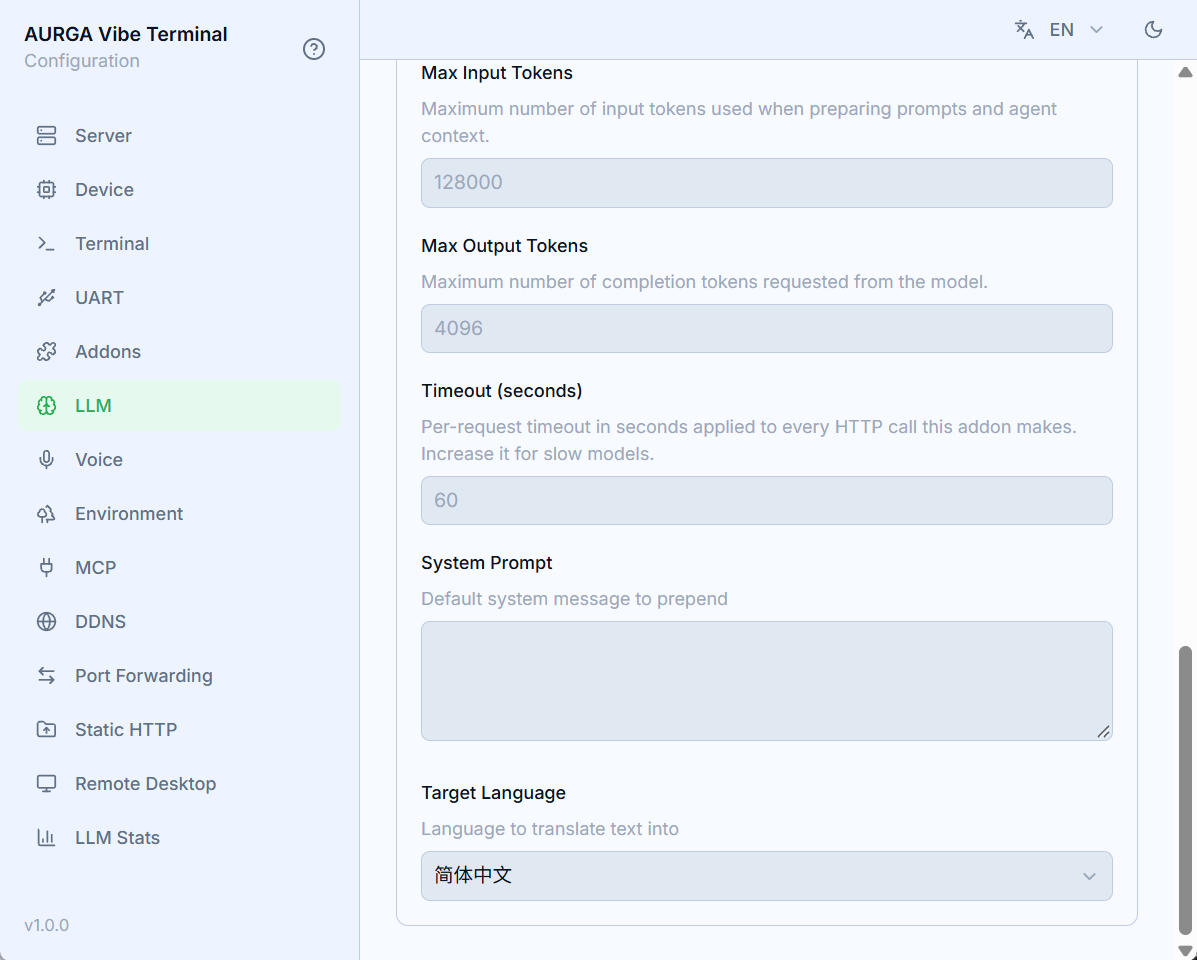
Zielsprache, in der jede Übersetzung erscheint.
Die Konfiguration wird auch im deaktivierten Zustand gespeichert, aber der Server wendet sie erst an, wenn der Schalter an ist. Ohne ihn scheitern Client-Anfragen mit “translation addon is not configured or disabled”.
Zielsprache
Anders als die Terminal- und Git-Funktionen hat die Übersetzung keine Automatisch-Option — sie übersetzt immer in genau eine Sprache aus der Liste (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). Die Einstellung gilt serverweit; ein Wechsel wirkt sich nur auf neue Anfragen aus. Eine unsetzte Sprache fällt auf Englisch zurück.
Wiederverwendung der Provider-Zugangsdaten
Die Kopieren-/Einfügen-Buttons neben der Überschrift Anbieterkonfiguration klonen Feldwerte zwischen Funktionskarten, die dasselbe Provider-Addon nutzen — wählen und füllen Sie den Provider einmal (etwa für Git-Commit-Meldungen), drücken Sie Kopieren und dann Einfügen in der Übersetzungskarte.
Modellwahl
Übersetzungen sind kurze, latenzempfindliche Prompts — ein schnelles Modell schlägt ein großes Reasoning-Modell. Qwen3.5 9B hinter einem OpenAI-kompatiblen Endpunkt (Ollama, vLLM, llama.cpp) oder DeepSeek V4 Flash per API funktionieren beide gut. Der Server wartet bis zu 60 Sekunden pro Anfrage; für langsame lokale Modelle erhöhen Sie gegebenenfalls Timeout in den Provider-Feldern.
Denkmodus fügt Sekunden Latenz hinzu, ohne hier Qualitätsgewinn zu bringen — deaktivieren Sie ihn im
Extra Body, z. B.{"enable_thinking": false}für Qwen oder{"thinking": {"type": "disabled"}}für DeepSeek.