Documentatie
Serverinstellingen
Vertaling is een LLM-taak per functie die eenmalig op de server wordt geconfigureerd. Elk vertaalverzoek van elke client — chatberichten, commitconcepten, editor- en diff-selecties — loopt via dezelfde instellingen.
De functie inschakelen
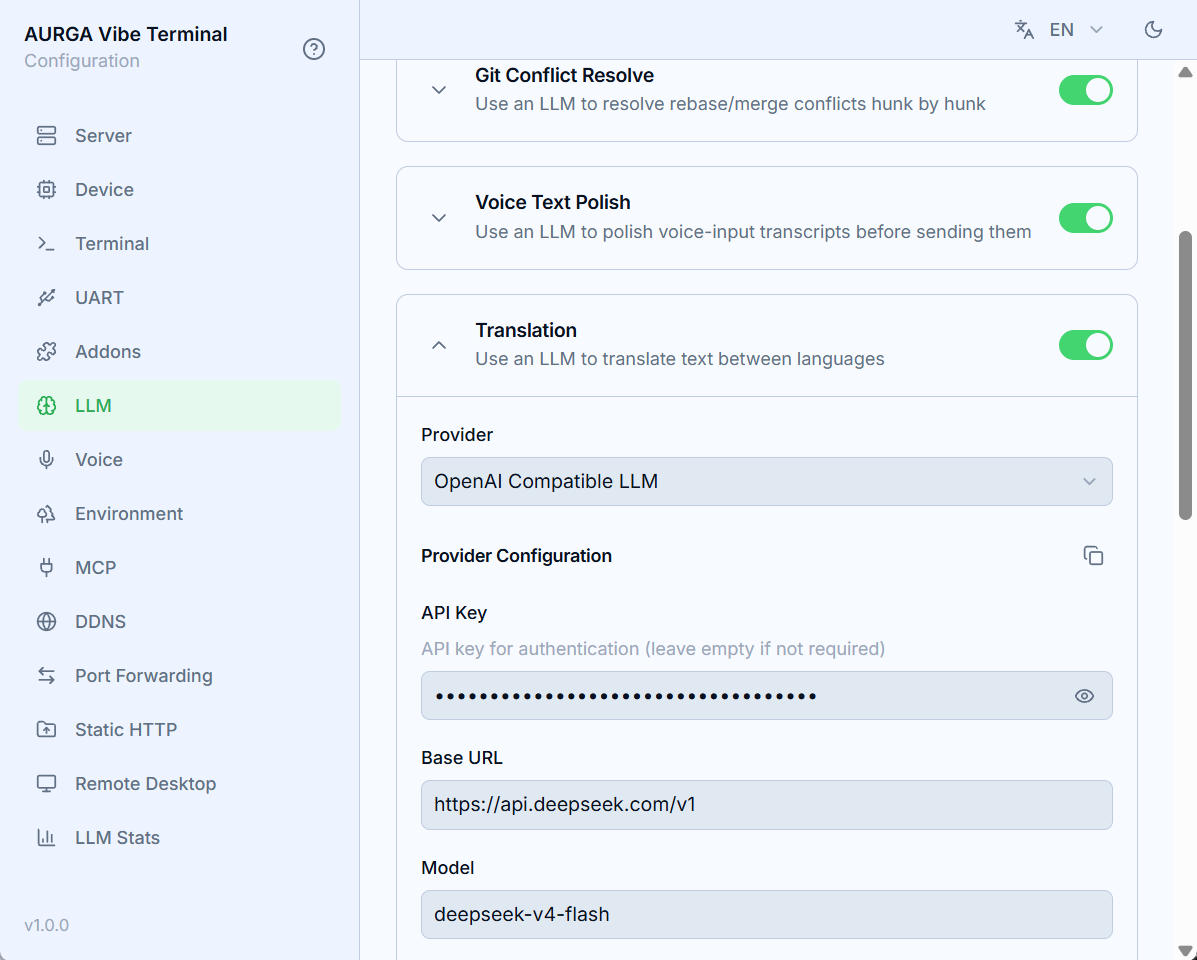
Open de sectie LLM van de Web UI en zoek de kaart Vertaling:
- Zet
LLM-vertaling inschakelenaan; - Kies een
Provider— de dropdown toont LLM-addons die in de sectieAdd-onsingeschakeld zijn (de ingebouwde provider OpenAI Compatible LLM dekt de meeste gevallen); - Vul de velden van de provider in onder
Providerconfiguratie(voor de ingebouwde:Base URL,API Key,Model, en optioneelExtra Body, tokenlimieten,Timeout); - Kies de
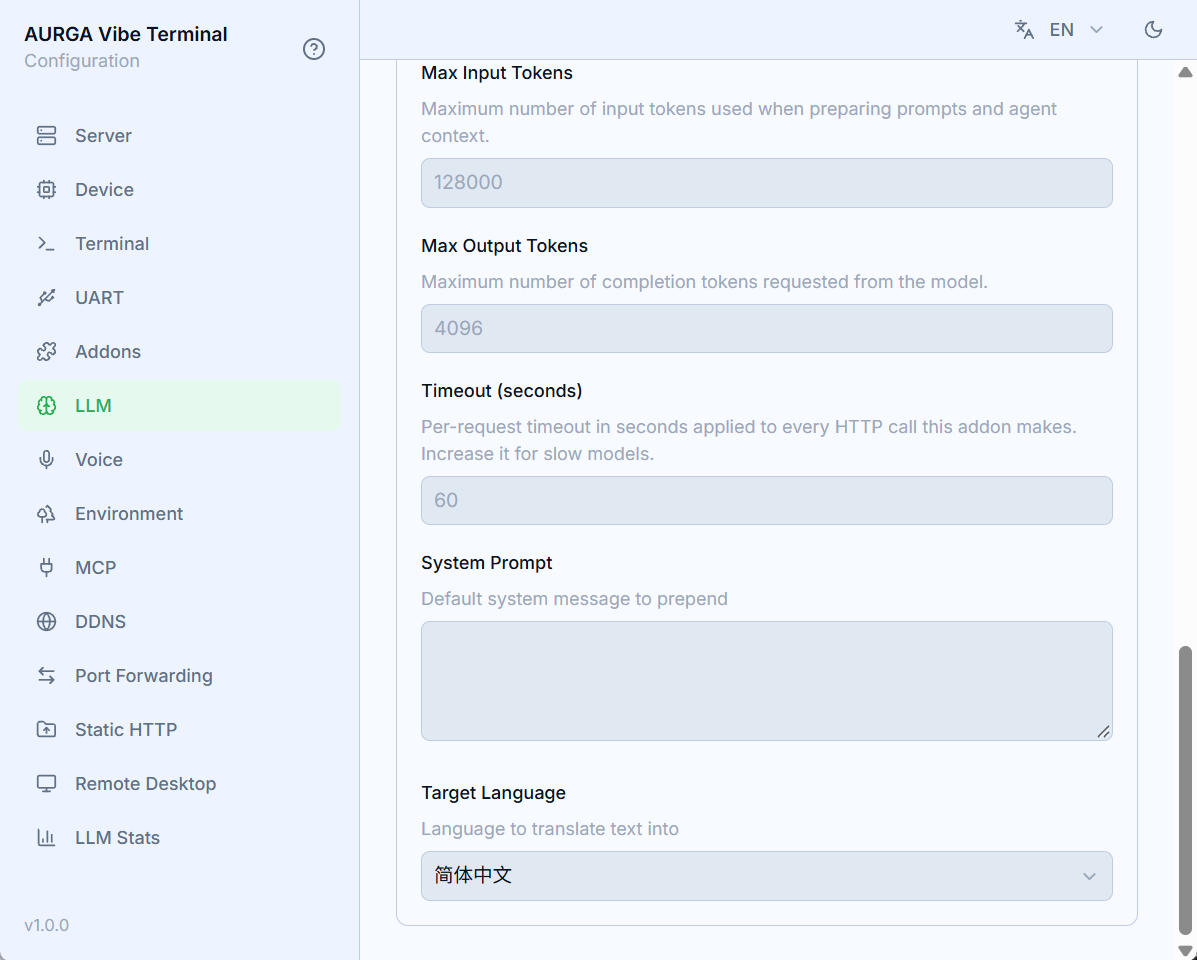
Doeltaalwaarin elke vertaling wordt geschreven.
De configuratie wordt ook bewaard terwijl de functie uit staat, maar de server past haar pas toe zodra de schakelaar aan staat. Zonder dat falen clientverzoeken met “translation addon is not configured or disabled”.
Doeltaal
Anders dan de terminal- en Git-functies heeft vertaling geen Automatisch-optie — er wordt altijd vertaald naar één expliciete taal uit de lijst (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). De instelling geldt serverbreed; wisselen beïnvloedt alleen nieuwe verzoeken. Een niet-ingestelde taal valt terug op Engels.
Providergegevens hergebruiken
De kopieer/plak-knoppen naast de kop Providerconfiguratie klonen veldwaarden tussen functiekaarten die dezelfde provider-addon gebruiken — kies en vul de provider één keer (bijvoorbeeld voor Git-commitberichten), druk op Kopiëren en daarna op Plakken in de Vertaling-kaart.
Een model kiezen
Vertalingen zijn korte, latentiegevoelige prompts — een snel model verslaat een groot redeneermodel. Qwen3.5 9B achter een OpenAI-compatibel endpoint (Ollama, vLLM, llama.cpp) of DeepSeek V4 Flash via API werken beide goed. De server wacht tot 60 seconden per verzoek; trage lokale modellen hebben mogelijk een hogere Timeout nodig in de providervelden.
Denkmodus voegt seconden latentie toe zonder kwaliteitswinst hier — zet het uit in
Extra Body, bv.{"enable_thinking": false}voor Qwen of{"thinking": {"type": "disabled"}}voor DeepSeek.