Documentation
Configuration du serveur
La traduction est une tâche LLM par fonction, à configurer une fois sur le serveur. Chaque requête de traduction de n’importe quel client — messages de chat, brouillons de commit, sélections de l’éditeur et des diffs — passe par les mêmes réglages.
Activer la fonction
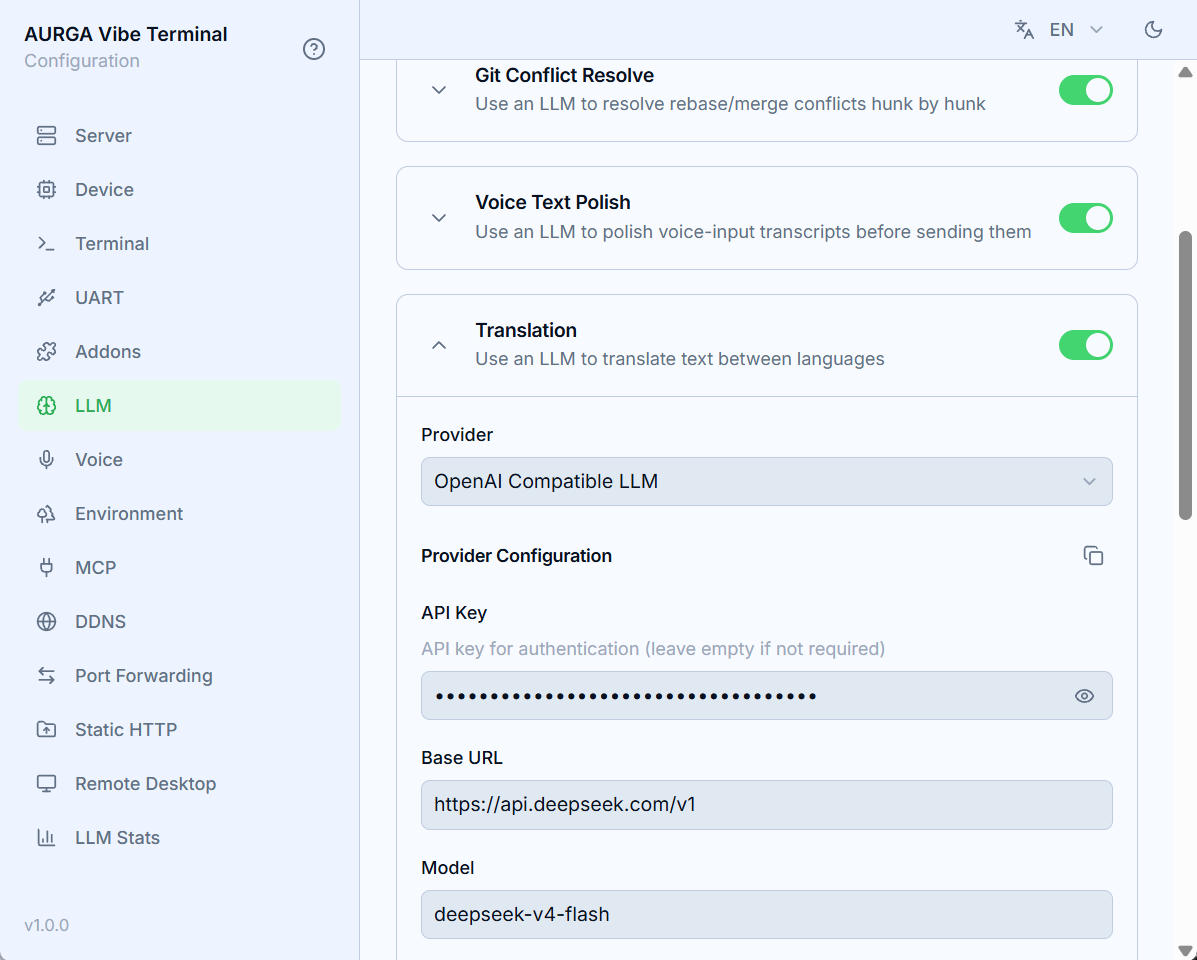
Ouvrez la section LLM de l’interface Web et repérez la carte Traduction :
- Activez
Activer la traduction par LLM; - Choisissez un
Fournisseur— la liste déroulante n’affiche que les addons LLM activés dans la sectionAddons(le fournisseur intégré OpenAI Compatible LLM couvre la plupart des cas) ; - Remplissez les champs du fournisseur sous
Configuration du fournisseur(pour le fournisseur intégré :Base URL,API Key,Model, et en optionExtra Body, limites de tokens,Timeout) ; - Choisissez la
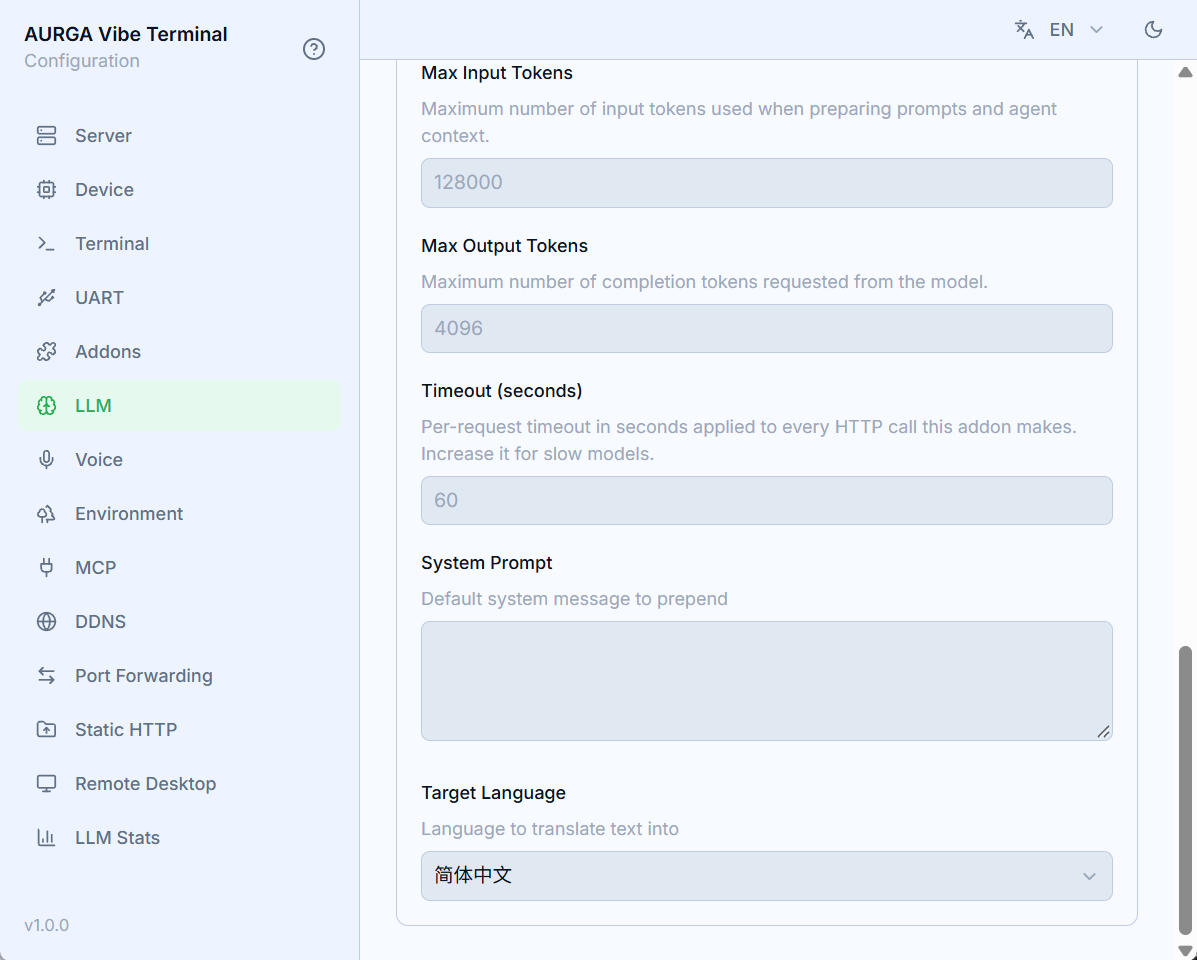
Langue cibledans laquelle chaque traduction sera écrite.
La configuration est sauvegardée même quand la fonction est désactivée, mais le serveur ne l’applique qu’une fois l’interrupteur allumé. Sans lui, les requêtes clientes échouent avec “translation addon is not configured or disabled”.
Langue cible
Contrairement aux fonctions terminal et Git, la traduction n’a pas d’option Auto — elle traduit toujours vers une langue explicite de la liste (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). Le réglage s’applique à tout le serveur ; le changer n’affecte que les nouvelles requêtes. Une langue non définie revient à l’anglais.
Réutiliser les identifiants d’un fournisseur
Les boutons copier/coller à côté du titre Configuration du fournisseur clonent les valeurs de champs entre cartes de fonction qui utilisent le même addon fournisseur — choisissez et remplissez le fournisseur une fois (par exemple pour les messages de commit Git), appuyez sur Copier, puis sur Coller dans la carte Traduction.
Choisir un modèle
Les traductions sont des prompts courts et sensibles à la latence — un modèle rapide bat un grand modèle de raisonnement. Qwen3.5 9B derrière un point de terminaison compatible OpenAI (Ollama, vLLM, llama.cpp) ou DeepSeek V4 Flash via API fonctionnent tous deux bien. Le serveur attend jusqu’à 60 secondes par requête ; les modèles locaux lents peuvent nécessiter un Timeout plus élevé dans les champs du fournisseur.
Le mode réflexion ajoute des secondes de latence sans gain de qualité ici — désactivez-le dans
Extra Body, p. ex.{"enable_thinking": false}pour Qwen ou{"thinking": {"type": "disabled"}}pour DeepSeek.