Dokumentasi
Persediaan Pelayan
Terjemahan ialah tugas LLM mengikut ciri yang dikonfigurasi sekali di pelayan. Setiap permintaan terjemahan daripada mana-mana klien — mesej sembang, draf commit, pemilihan editor dan diff — melalui tetapan yang sama.
Mengaktifkan ciri
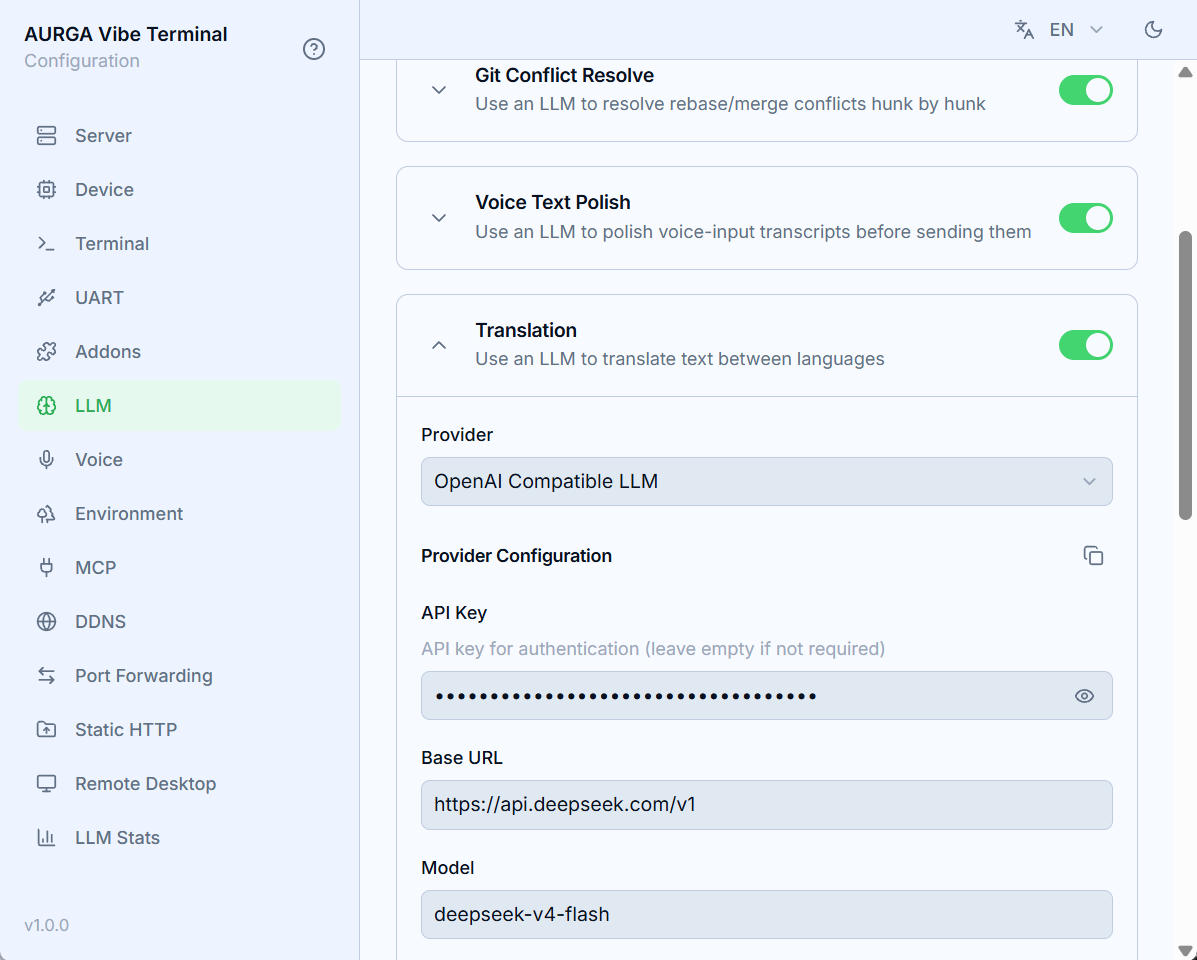
Buka bahagian LLM dalam Web UI dan cari kad Translation:
- Hidupkan
Enable LLM translation; - Pilih
Provider— senarai juntai bawah menyenaraikan addon LLM yang diaktifkan dalam bahagianTambahan(provider terbina dalam OpenAI Compatible LLM merangkumi kebanyakan kes); - Isi medan provider di bawah
Provider Configuration(untuk yang terbina dalam:Base URL,API Key,Model, dan pilihanExtra Body, had token,Timeout); - Pilih
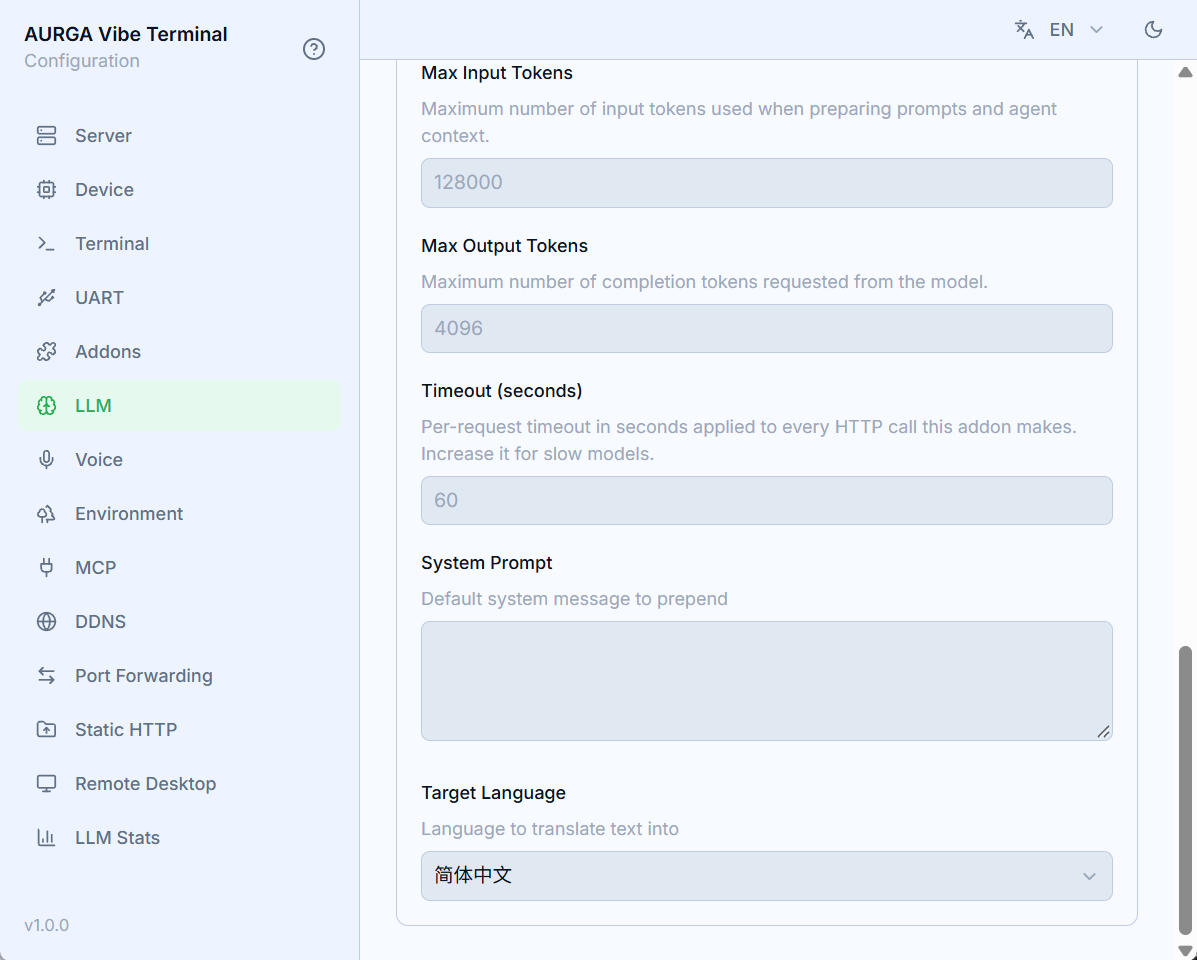
Target Languageyang digunakan untuk setiap terjemahan.
Konfigurasi disimpan walaupun ciri dilumpuhkan, tetapi pelayan hanya menerapkannya setelah suis dihidupkan. Tanpanya, permintaan klien gagal dengan “translation addon is not configured or disabled”.
Bahasa sasaran
Berbeza dengan ciri terminal dan Git, terjemahan tiada pilihan Auto — ia sentiasa menterjemah kepada satu bahasa eksplisit daripada senarai (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). Tetapan ini berkesan untuk seluruh pelayan; menukarnya hanya menjejaskan permintaan baharu. Bahasa yang tidak ditetapkan kembali kepada Inggeris.
Menggunakan semula kredensial provider
Butang salin/tampal di sebelah tajuk Provider Configuration mengklon nilai medan antara kad ciri yang menggunakan addon provider yang sama — pilih dan isi provider sekali (contohnya untuk mesej commit Git), tekan Copy, kemudian Paste dalam kad Translation.
Memilih model
Terjemahan ialah prompt pendek yang sensitif kepada latensi — model pantas mengatasi model penaakulan besar. Qwen3.5 9B di sebalik endpoint serasi OpenAI (Ollama, vLLM, llama.cpp) atau DeepSeek V4 Flash melalui API kedua-duanya berfungsi dengan baik. Pelayan menunggu sehingga 60 saat setiap permintaan; model tempatan yang perlahan mungkin memerlukan Timeout lebih tinggi dalam medan provider.
Mod berfikir menambah beberapa saat latensi tanpa peningkatan kualiti di sini — matikan dalam
Extra Body, cth.{"enable_thinking": false}untuk Qwen atau{"thinking": {"type": "disabled"}}untuk DeepSeek.