ドキュメント
サーバー設定
翻訳は機能ごとの LLM ジョブで、サーバーで一度設定するだけです。任意のクライアントからの翻訳リクエスト——チャットメッセージ、コミット下書き、エディターと差分の選択範囲——はすべて同じ設定を通ります。
機能を有効にする
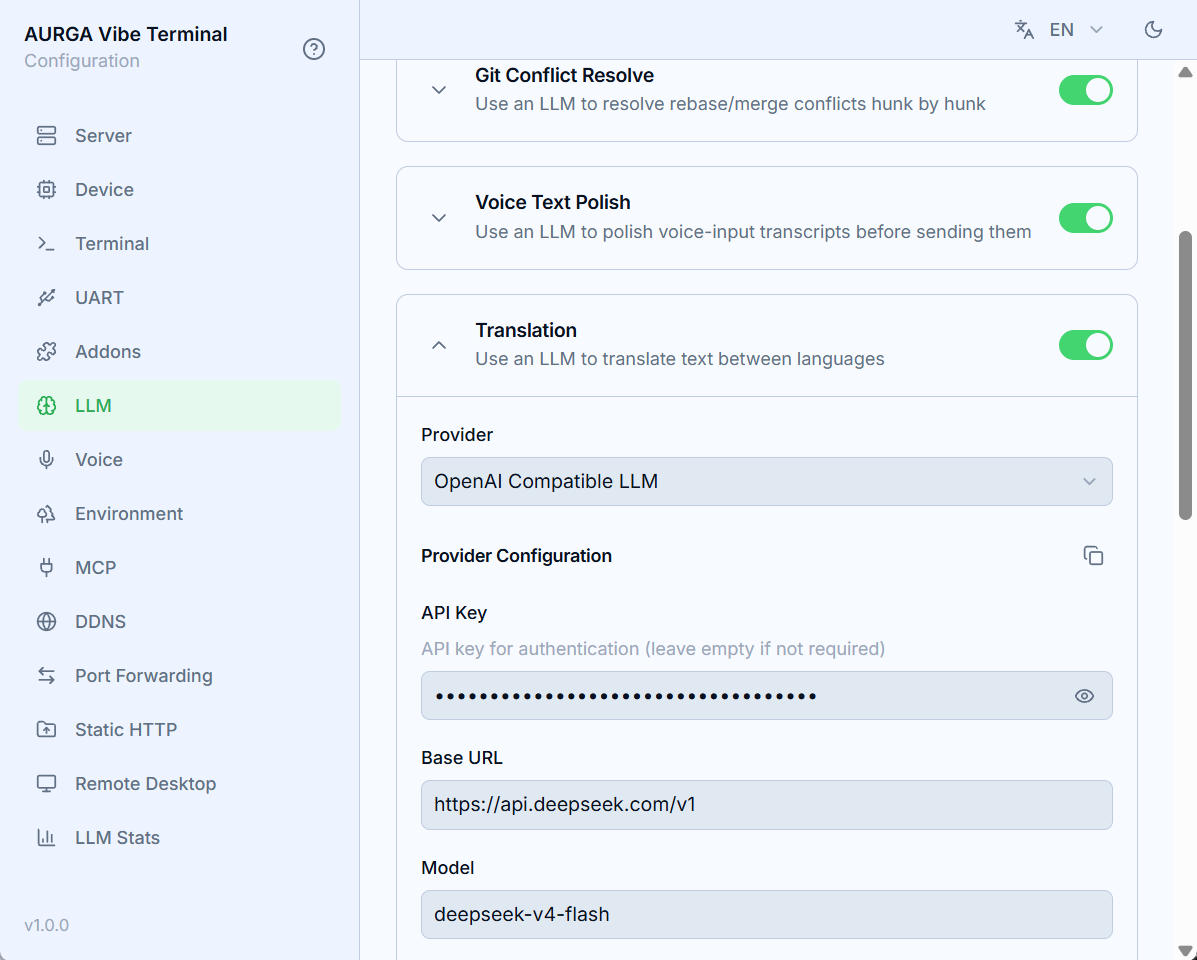
Web UI の LLM セクションを開き、翻訳 カードを見つけます:
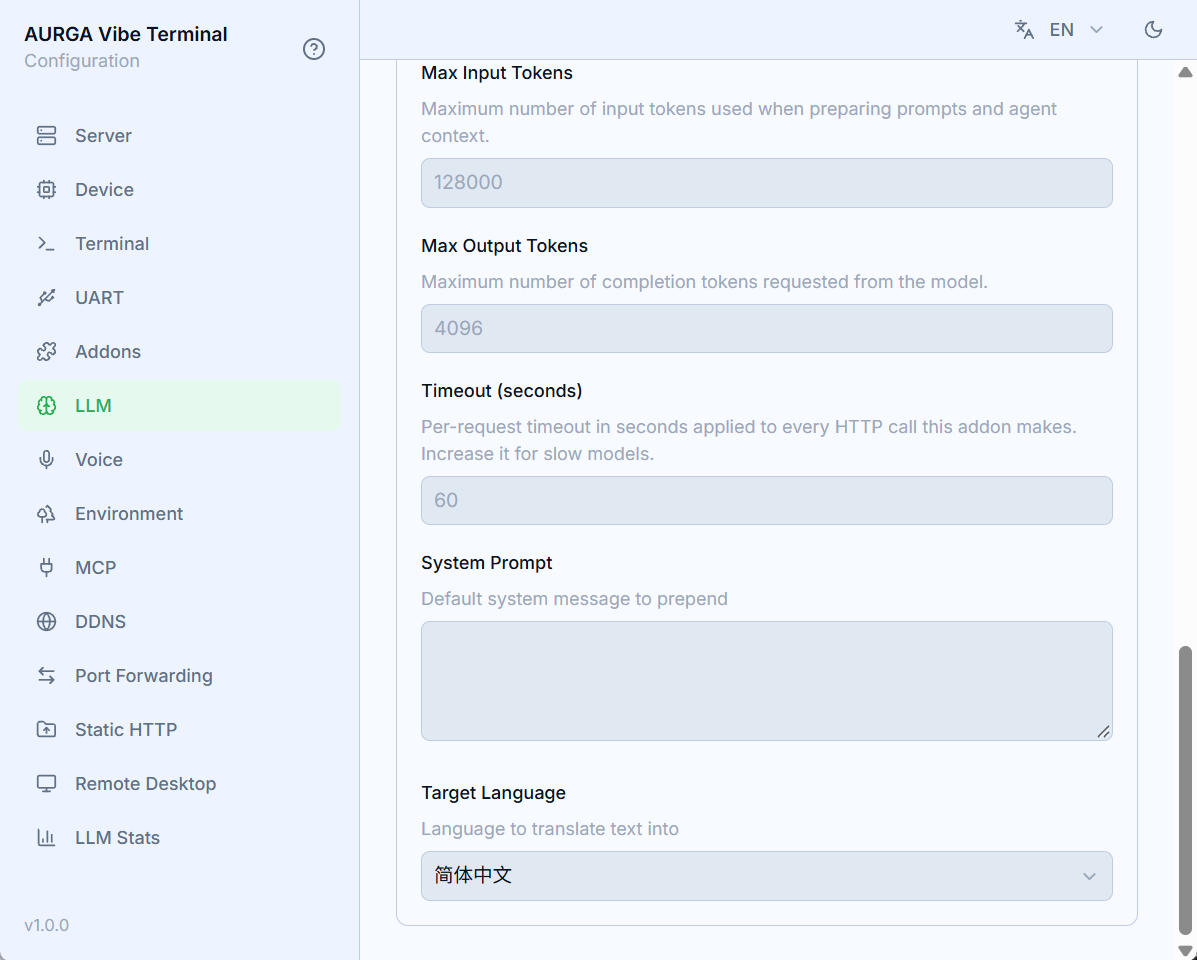
LLM 翻訳を有効化をオンにします;プロバイダーを選びます——ドロップダウンにはアドオンセクションで有効になっている LLM アドオンだけが表示されます(内蔵の OpenAI Compatible LLM プロバイダーで大半のケースをカバーできます);プロバイダー設定のフィールドを埋めます(内蔵プロバイダーではBase URL、API Key、Model、任意でExtra Body、トークン上限、Timeout);- すべての訳文の言語となる
翻訳先の言語を選びます。
設定は機能無効の間も保存されますが、スイッチをオンにして初めてサーバーに適用されます。無効のままでは、クライアントのリクエストは “translation addon is not configured or disabled” で失敗します。
ターゲット言語
ターミナルや Git 機能と異なり、翻訳に 自動 オプションはありません——常にリストから明示的な 1 言語へ翻訳します(English、简体中文、繁體中文、Deutsch、Español、Français、日本語、한국어、Nederlands、Polski、Português、Русский、ไทย、Tiếng Việt、العربية、Bahasa Indonesia、Bahasa Melayu、Українська)。この設定はサーバー全体に適用され、切り替えは新しいリクエストにのみ影響します。未設定の場合は英語にフォールバックします。
プロバイダー資格情報の再利用
プロバイダー設定 見出し横のコピー/ペーストボタンは、同じプロバイダーアドオンを使う機能カード間でフィールド値を複製します——あるカード(例えば Git コミットメッセージ)でプロバイダーを選んで埋め、コピー を押し、翻訳カードで 貼り付け します。
モデル選び
翻訳は短くレイテンシ敏感なプロンプトです——高速なモデルが大型推論モデルに勝ります。OpenAI 互換エンドポイント(Ollama、vLLM、llama.cpp)越しの Qwen3.5 9B、または API 経由の DeepSeek V4 Flash がどちらもよく機能します。サーバーはリクエストごとに最大 60 秒待ちます。遅いローカルモデルではプロバイダーフィールドの Timeout を大きくしてください。
思考モードは数秒のレイテンシを加えるだけで品質に寄与しません——
Extra Bodyで無効にしてください。例えば Qwen は{"enable_thinking": false}、DeepSeek は{"thinking": {"type": "disabled"}}。