文档
服务器配置
翻译是一个按功能配置的 LLM 任务,只需在服务器上配置一次。任何客户端发来的翻译请求——聊天消息、提交草稿、编辑器与差异选区——都走同一份设置。
启用功能
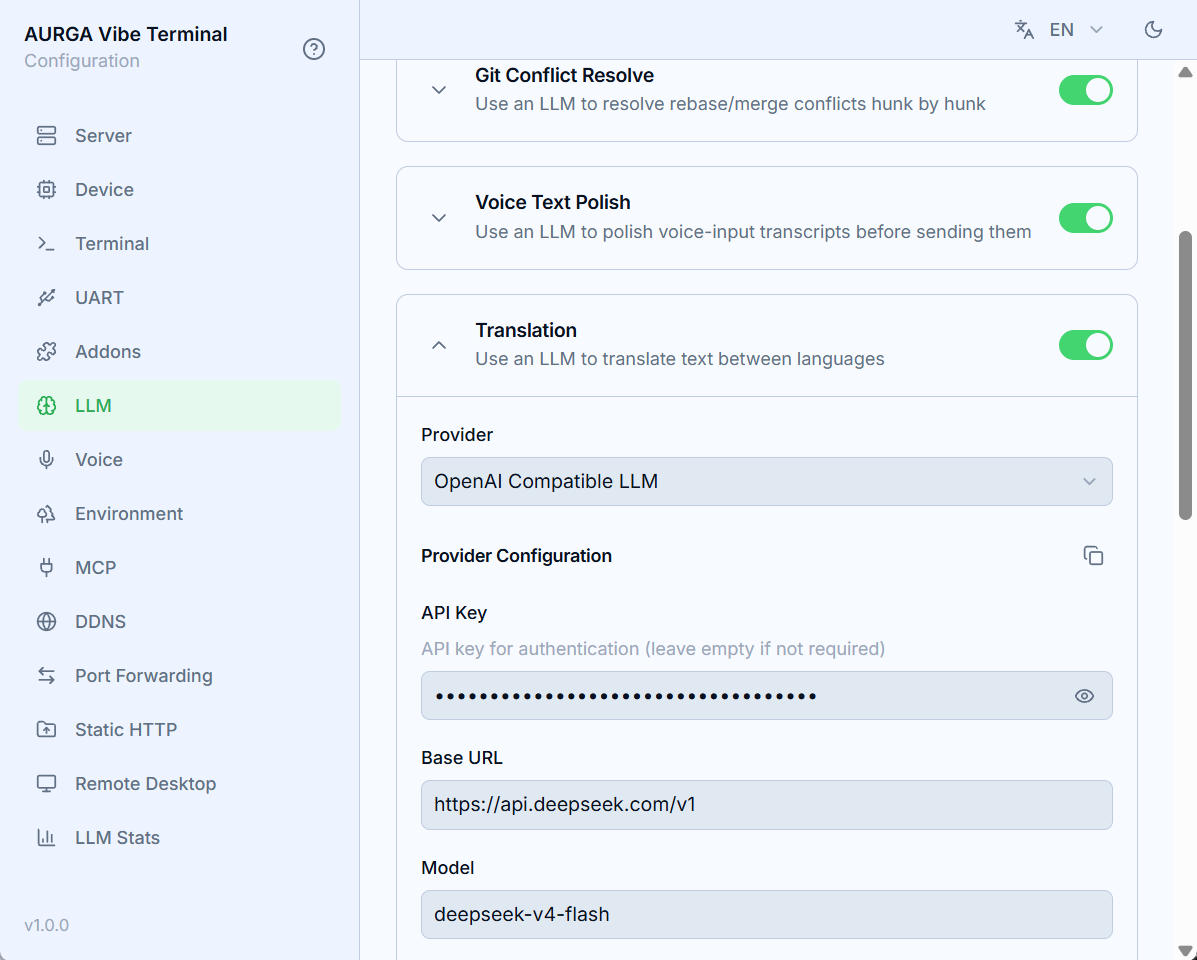
打开 Web 界面的 LLM 配置 页,找到 翻译 卡片:
- 打开
启用 LLM 翻译开关; - 选择
提供商——下拉列表只显示插件页中已启用的 LLM 插件(内置的 OpenAI Compatible LLM 提供商可覆盖大多数场景); - 填写
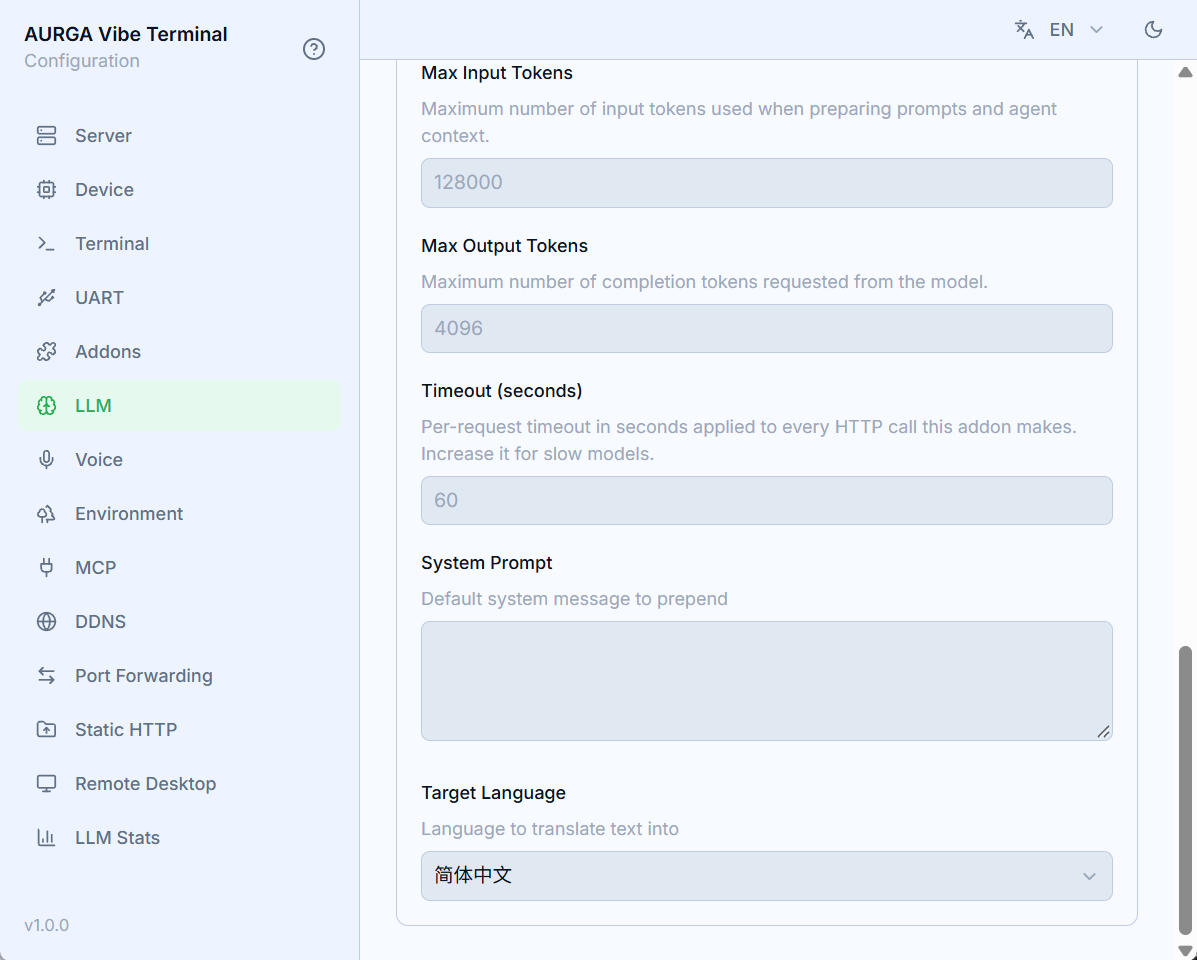
提供商配置中的字段(内置提供商为:Base URL、API Key、Model,以及可选的Extra Body、token 上限、Timeout); - 选择所有译文使用的
目标语言。
功能停用时配置也会保存,但只有开关打开后服务器才会应用它。未启用时,客户端请求会失败并提示 “translation addon is not configured or disabled”。
目标语言
与终端和 Git 功能不同,翻译没有 自动 选项——它始终翻译为列表中某个明确的语言(English、简体中文、繁體中文、Deutsch、Español、Français、日本語、한국어、Nederlands、Polski、Português、Русский、ไทย、Tiếng Việt、العربية、Bahasa Indonesia、Bahasa Melayu、Українська)。该设置对整个服务器生效;切换后只影响新请求。未设置时默认英语。
复用提供商凭据
提供商配置 标题旁的复制/粘贴按钮可以在使用同一提供商插件的卡片之间克隆字段值——先在一张卡片(比如 Git 提交信息)里选好并填完提供商,点击复制,再在翻译卡片里粘贴。
选择模型
翻译是短小、对延迟敏感的提示词——快模型胜过大型推理模型。OpenAI 兼容端点(Ollama、vLLM、llama.cpp)后的 Qwen3.5 9B,或走 API 的 DeepSeek V4 Flash 都很合适。服务器单次请求最多等待 60 秒;本地慢模型可在提供商字段中调大 Timeout。
思考模式会增加数秒延迟,在这里毫无收益——建议在
Extra Body中关闭,例如 Qwen 用{"enable_thinking": false},DeepSeek 用{"thinking": {"type": "disabled"}}。