เอกสาร
การตั้งค่าเซิร์ฟเวอร์
การแปลภาษาเป็นงาน LLM รายคุณสมบัติที่กำหนดค่าบนเซิร์ฟเวอร์ครั้งเดียว คำขอแปลจากไคลเอนต์ใดก็ตาม — ข้อความแชท ร่างคอมมิต การเลือกในตัวแก้ไขและ diff — ผ่านการตั้งค่าชุดเดียวกันหมด
เปิดใช้คุณสมบัติ
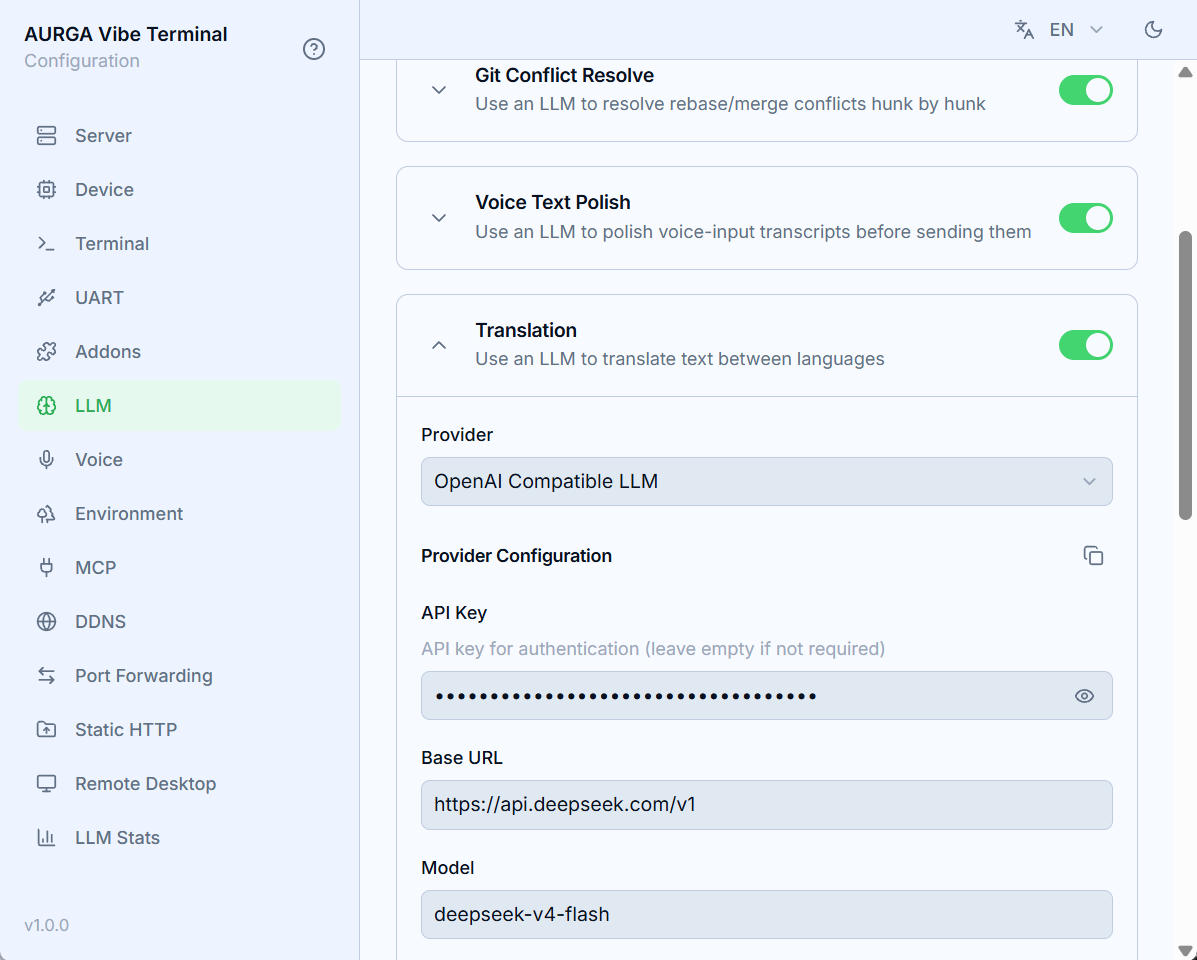
เปิดส่วน LLM ของเว็บ UI แล้วหาการ์ด การแปลภาษา:
- เปิด
เปิดใช้งานการแปลด้วย LLM; - เลือก
ผู้ให้บริการ— รายการแบบเลื่อนแสดงเฉพาะ addon LLM ที่เปิดใช้อยู่ในส่วนส่วนเสริม(provider ในตัว OpenAI Compatible LLM ครอบคลุมกรณีส่วนใหญ่); - กรอกฟิลด์ของ provider ใต้
การกำหนดค่าผู้ให้บริการ(สำหรับตัวในเครื่อง:Base URL,API Key,ModelและทางเลือกExtra Body, ขีดจำกัดโทเคน,Timeout); - เลือก
ภาษาเป้าหมายที่การแปลทุกครั้งจะเขียนเป็น
การกำหนดค่าถูกบันทึกแม้คุณสมบัติจะปิดอยู่ แต่เซิร์ฟเวอร์จะใช้มันเมื่อสวิตช์เปิดเท่านั้น หากไม่เปิด คำขอจากไคลเอนต์ล้มเหลวพร้อมข้อความ “translation addon is not configured or disabled”
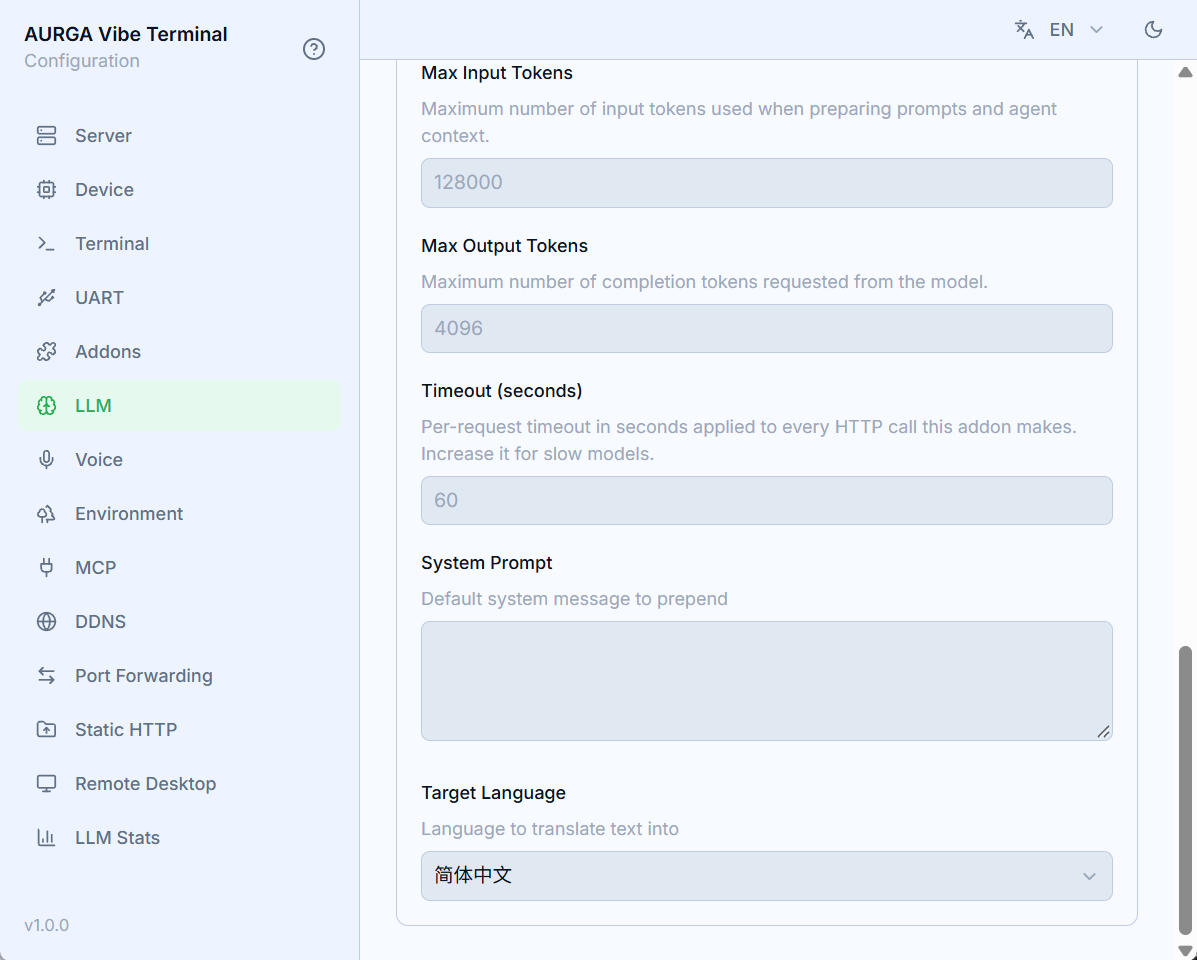
ภาษาเป้าหมาย
ต่างจากคุณสมบัติเทอร์มินัลและ Git การแปลไม่มีตัวเลือก อัตโนมัติ — มันแปลเป็นภาษาเดียวที่ระบุชัดจากรายการเสมอ (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська) การตั้งค่ามีผลทั้งเซิร์ฟเวอร์ การเปลี่ยนมีผลเฉพาะคำขอใหม่ ภาษาที่ไม่ได้ตั้งจะเป็นอังกฤษ
ใช้ข้อมูลรับรองของ provider ซ้ำ
ปุ่มคัดลอก/วางข้างหัวข้อ การกำหนดค่าผู้ให้บริการ โคลนค่าฟิลด์ระหว่างการ์ดคุณสมบัติที่ใช้ addon provider เดียวกัน — เลือกและกรอก provider ครั้งเดียว (เช่น สำหรับข้อความคอมมิต Git) กด คัดลอก แล้วกด วาง ในการ์ดการแปลภาษา
การเลือกโมเดล
การแปลเป็นพรอมต์สั้นและไวต่อความหน่วง — โมเดลเร็วชนะโมเดลใหญ่แบบใช้เหตุผล Qwen3.5 9B หลัง endpoint ที่เข้ากันได้กับ OpenAI (Ollama, vLLM, llama.cpp) หรือ DeepSeek V4 Flash ผ่าน API ทำงานได้ดีทั้งคู่ เซิร์ฟเวอร์รอได้ถึง 60 วินาทีต่อคำขอ โมเดลท้องถิ่นที่ช้าอาจต้องเพิ่ม Timeout ในฟิลด์ provider
โหมดคิดเพิ่มความหน่วงหลายวินาทีโดยไม่ช่วยคุณภาพที่นี่ — ปิดมันใน
Extra Bodyเช่น{"enable_thinking": false}สำหรับ Qwen หรือ{"thinking": {"type": "disabled"}}สำหรับ DeepSeek