문서
서버 설정
번역은 기능별 LLM 작업으로, 서버에서 한 번만 구성하면 됩니다. 모든 클라이언트의 번역 요청 — 채팅 메시지, 커밋 초안, 에디터와 diff 선택 — 은 같은 설정을 거칩니다.
기능 활성화
Web UI의 LLM 섹션을 열고 번역 카드를 찾으세요:
LLM 번역 사용을 켭니다;공급자를 고릅니다 — 드롭다운에는애드온섹션에서 활성화된 LLM 애드온만 나열됩니다(내장 OpenAI Compatible LLM 공급자가 대부분의 경우를 커버합니다);공급자 구성아래 필드를 채웁니다(내장 공급자 기준:Base URL,API Key,Model, 선택적으로Extra Body, 토큰 한도,Timeout);- 모든 번역에 사용될
대상 언어를 선택합니다.
구성은 기능이 비활성 상태여도 저장되지만, 스위치를 켜야 서버가 적용합니다. 꺼져 있으면 클라이언트 요청은 *“translation addon is not configured or disabled”*와 함께 실패합니다.
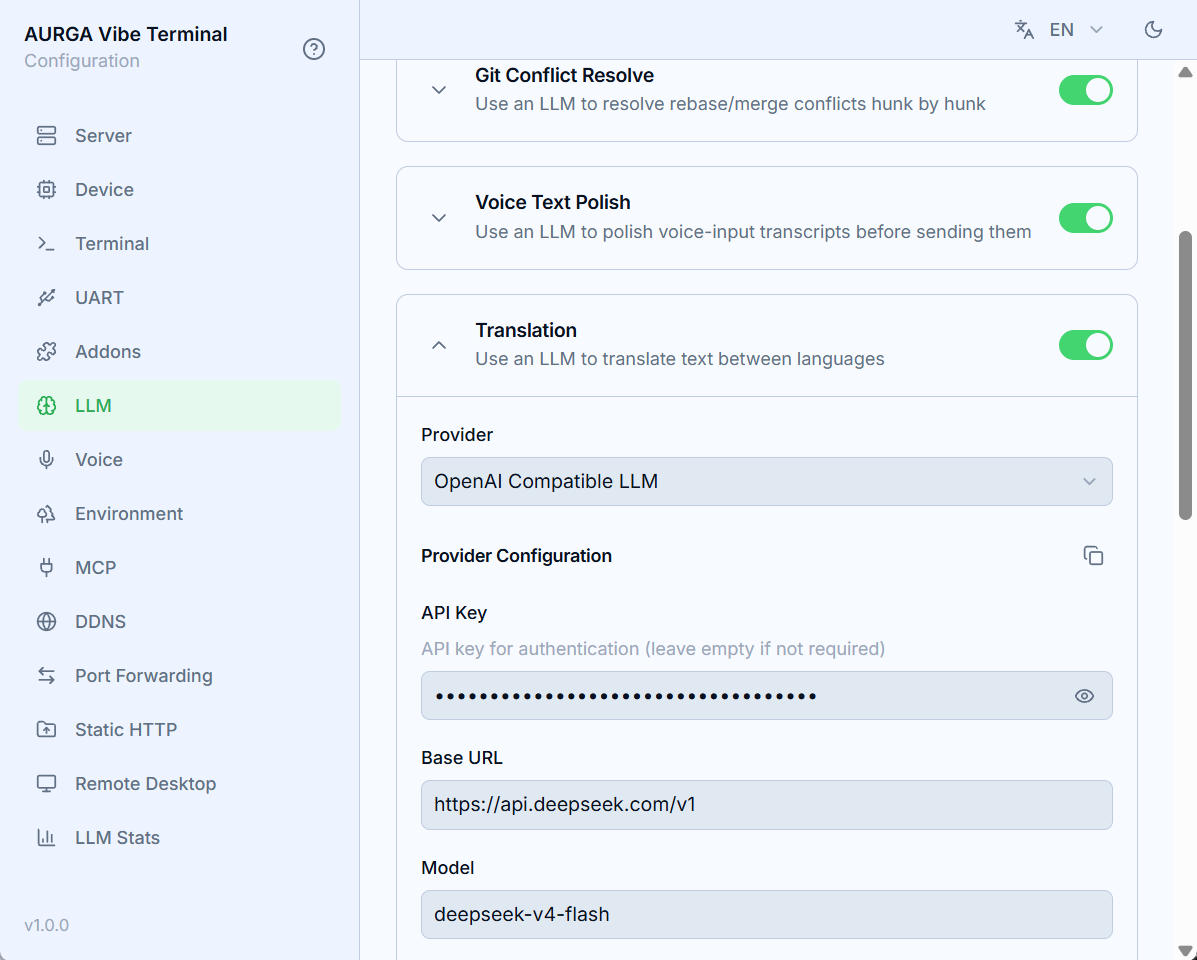
대상 언어
터미널과 Git 기능과 달리 번역에는 자동 옵션이 없습니다 — 항상 목록에서 명시적인 한 언어로 번역합니다(English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). 설정은 서버 전체에 적용되며, 변경은 새 요청에만 영향을 줍니다. 미설정 시 영어로 기본 설정됩니다.
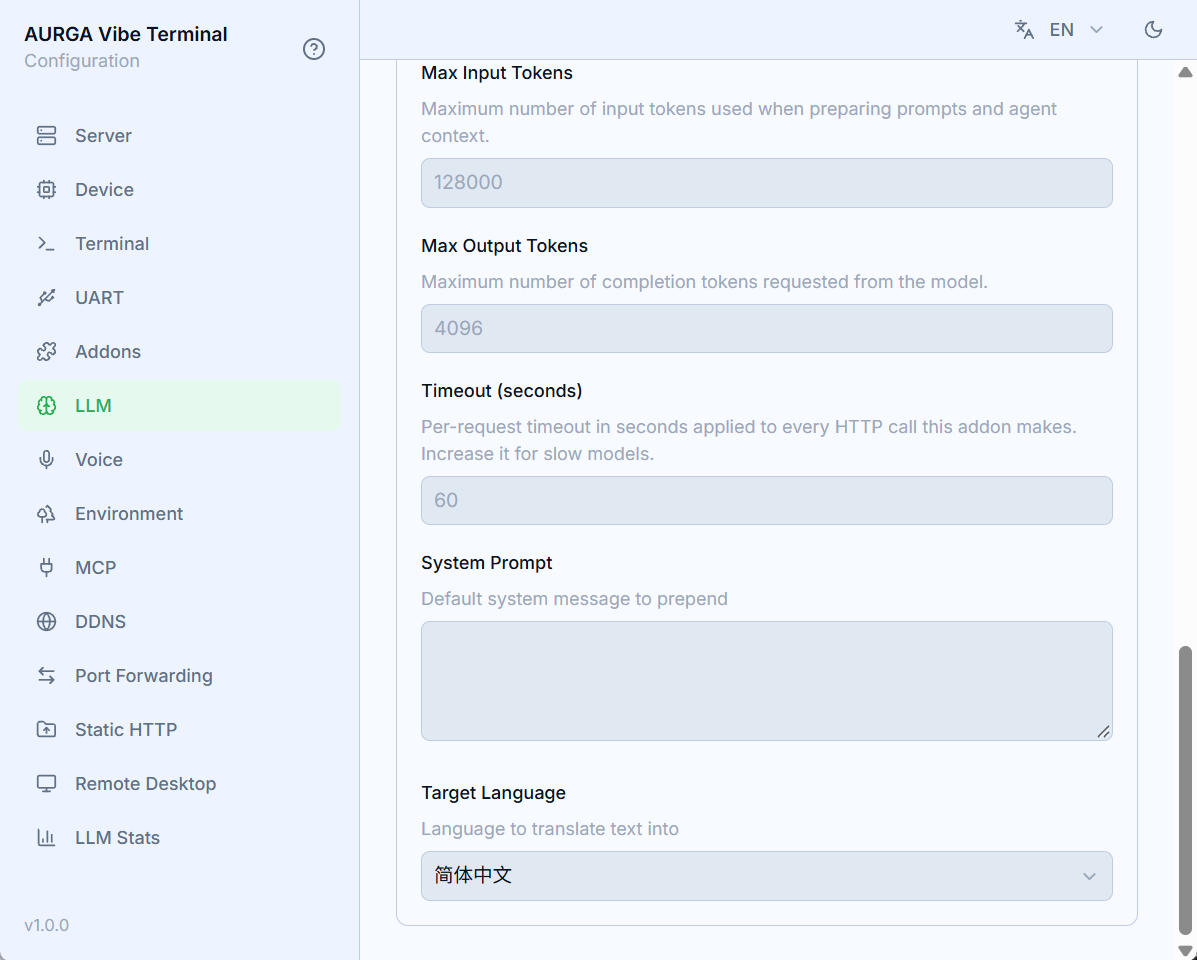
공급자 자격 증명 재사용
공급자 구성 제목 옆의 복사/붙여넣기 버튼은 같은 공급자 애드온을 쓰는 기능 카드 사이에서 필드 값을 복제합니다 — 한 카드(예: Git 커밋 메시지)에서 공급자를 선택하고 채운 뒤 복사를 누르고, 번역 카드에서 붙여넣기하면 됩니다.
모델 선택
번역은 짧고 지연에 민감한 프롬프트입니다 — 빠른 모델이 대형 추론 모델보다 낫습니다. OpenAI 호환 엔드포인트(Ollama, vLLM, llama.cpp) 뒤의 Qwen3.5 9B 또는 API 경유의 DeepSeek V4 Flash 모두 잘 동작합니다. 서버는 요청당 최대 60초까지 기다립니다. 느린 로컬 모델이라면 공급자 필드의 Timeout을 올리세요.
사고 모드는 수 초의 지연을 더할 뿐 품질 이득이 없습니다 —
Extra Body에서 끄세요. 예: Qwen은{"enable_thinking": false}, DeepSeek은{"thinking": {"type": "disabled"}}.