Dokumentasi
Penyiapan Server
Terjemahan adalah tugas LLM per fitur yang dikonfigurasi sekali di server. Setiap permintaan terjemahan dari klien mana pun — pesan chat, draf commit, seleksi editor dan diff — melewati setelan yang sama.
Mengaktifkan fitur
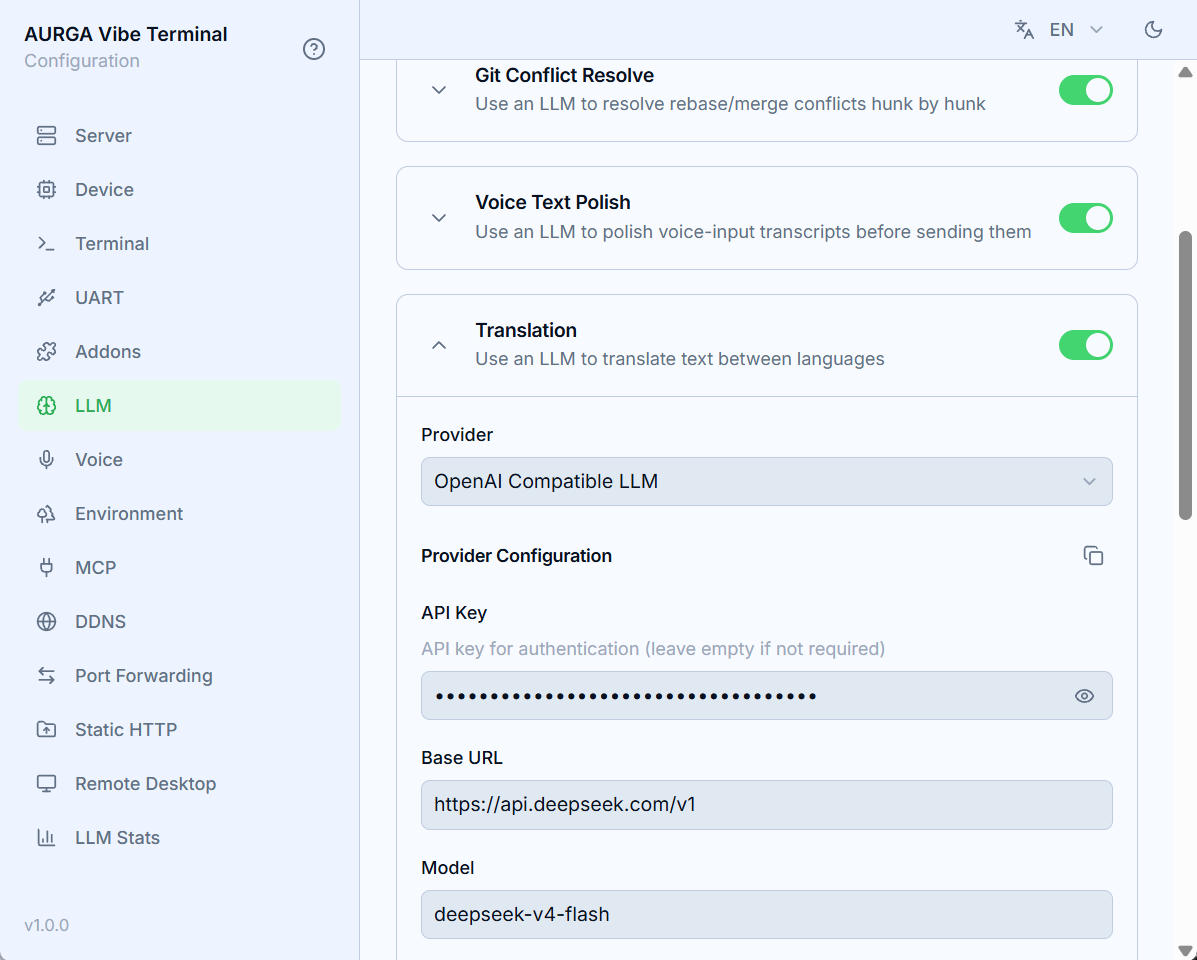
Buka bagian LLM pada Web UI dan temukan kartu Translation:
- Nyalakan
Enable LLM translation; - Pilih
Provider— dropdown mencantumkan addon LLM yang diaktifkan di bagianAdd-on(provider bawaan OpenAI Compatible LLM mencakup sebagian besar kasus); - Isi kolom provider di bawah
Provider Configuration(untuk provider bawaan:Base URL,API Key,Model, dan opsionalExtra Body, batas token,Timeout); - Pilih
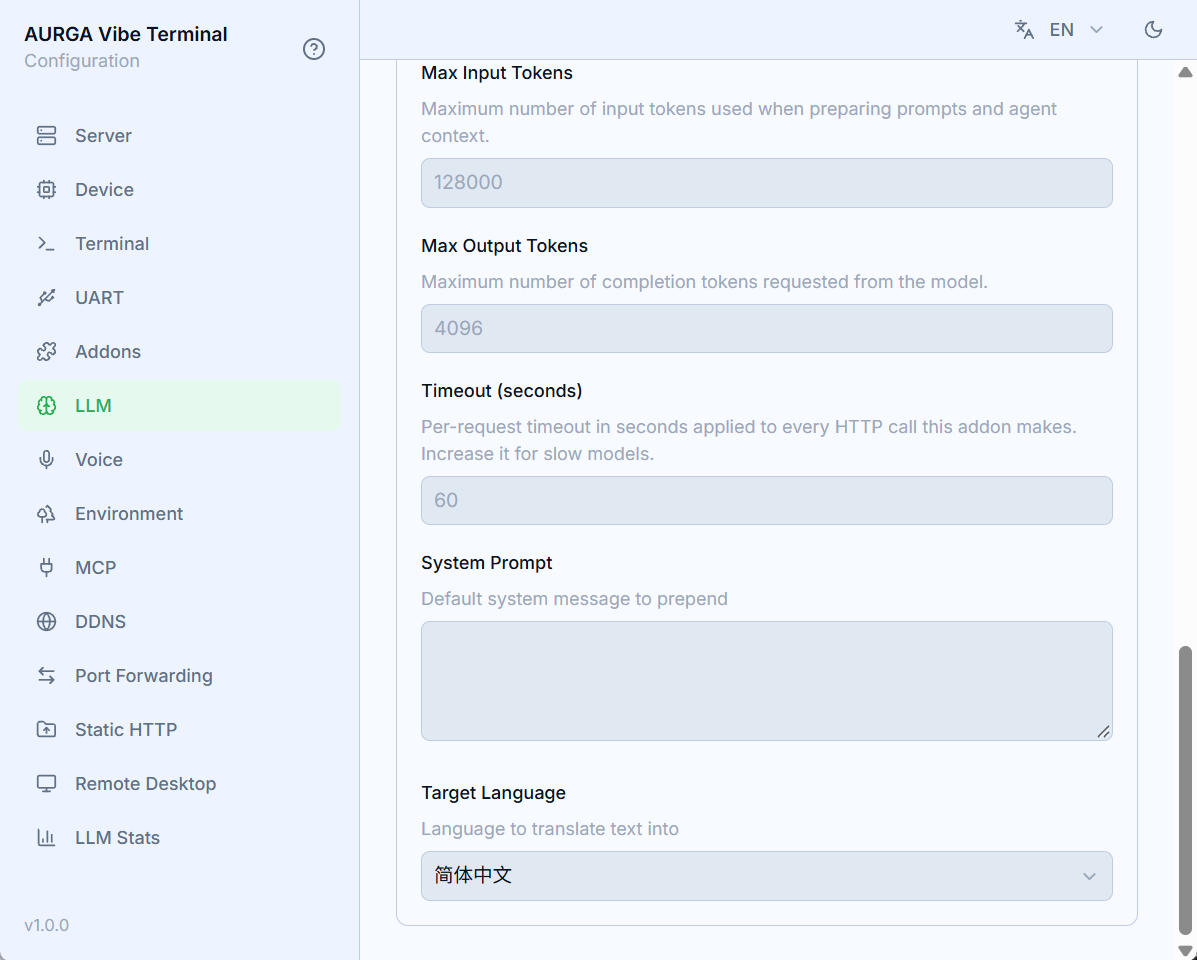
Target Languageyang dipakai untuk semua terjemahan.
Konfigurasi tersimpan meski fitur sedang nonaktif, tetapi server hanya menerapkannya setelah sakelarnya menyala. Tanpa itu, permintaan klien gagal dengan “translation addon is not configured or disabled”.
Bahasa sasaran
Berbeda dari fitur terminal dan Git, terjemahan tidak punya opsi Auto — selalu menerjemahkan ke satu bahasa eksplisit dari daftar (English, 简体中文, 繁體中文, Deutsch, Español, Français, 日本語, 한국어, Nederlands, Polski, Português, Русский, ไทย, Tiếng Việt, العربية, Bahasa Indonesia, Bahasa Melayu, Українська). Setelan berlaku server-wide; menggantinya hanya memengaruhi permintaan baru. Bahasa yang tak diatur jatuh kembali ke Inggris.
Memakai ulang kredensial provider
Tombol salin/tempel di samping judul Provider Configuration menggandakan nilai kolom antar kartu fitur yang memakai addon provider yang sama — pilih dan isi provider sekali (misalnya untuk pesan commit Git), tekan Copy, lalu Paste di kartu Translation.
Memilih model
Terjemahan adalah prompt pendek yang sensitif latensi — model cepat mengalahkan model penalaran besar. Qwen3.5 9B di balik endpoint kompatibel OpenAI (Ollama, vLLM, llama.cpp) atau DeepSeek V4 Flash lewat API keduanya bekerja baik. Server menunggu hingga 60 detik per permintaan; model lokal yang lambat mungkin perlu Timeout lebih tinggi di kolom provider.
Mode berpikir menambah detik latensi tanpa peningkatan kualitas di sini — matikan di
Extra Body, mis.{"enable_thinking": false}untuk Qwen atau{"thinking": {"type": "disabled"}}untuk DeepSeek.