文档
服务器配置
语音输入把说话变成终端输入:动口不动手,还可在发送前用 LLM 润色转写文本。识别由本地 ASR 服务器与本地模型完成——音频和文本都不出你的机器。本页讲服务器配置;桌面端体验见「客户端使用」。
Local ASR Server 卡片
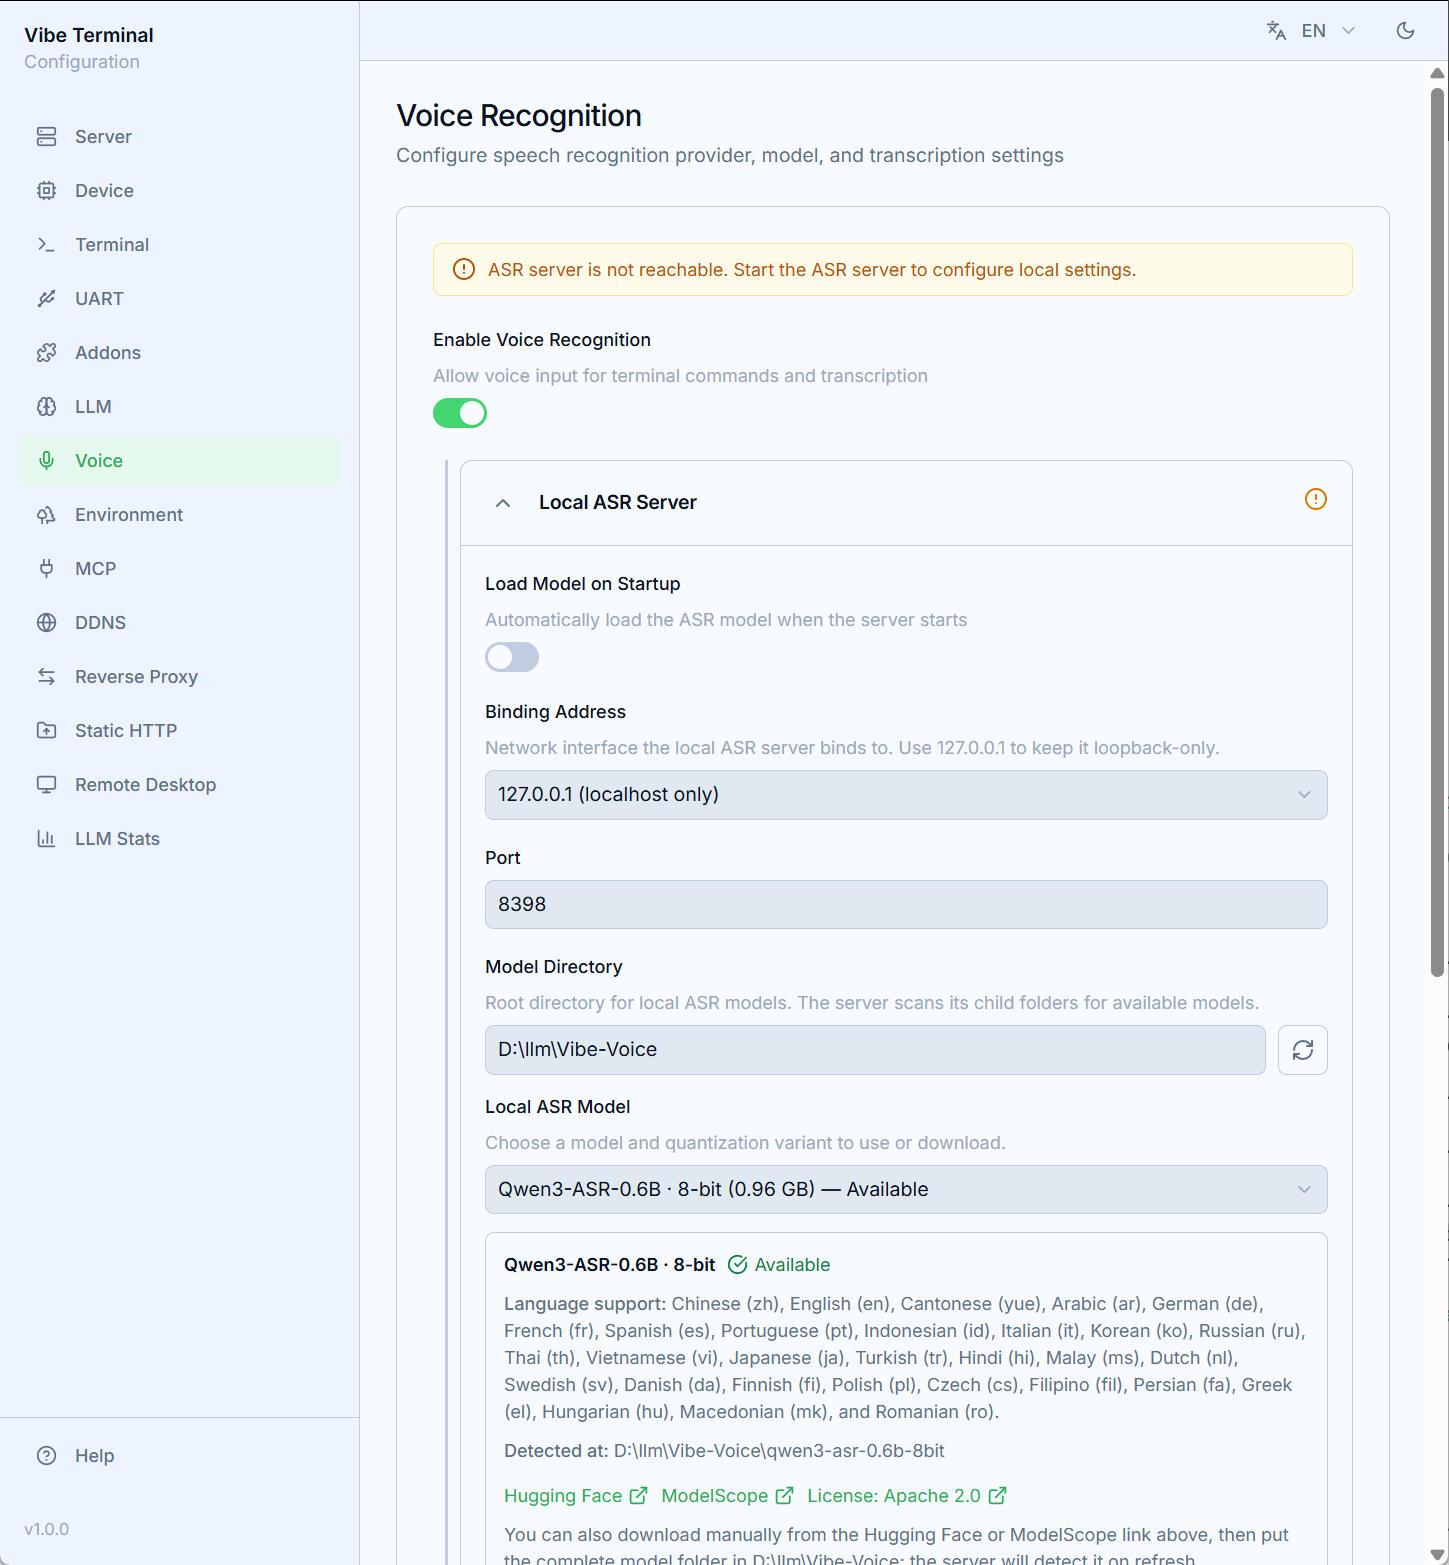
打开 Web 界面的 Voice 页并启用语音识别。Local ASR Server 卡片管理被守护的 vterm-voice 进程:
Load on Startup——随后端一起启动 ASR 服务器;Bind Address(127.0.0.1仅本机 /0.0.0.0所有网卡)与Port(默认8398)——ASR 端点的监听地址;Model Directory+Local Model——从内置目录选模型:Qwen3-ASR、Fun-ASR、Parakeet 三个家族,各有完整 / 8-bit / 4-bit 版本;Download从 Hugging Face 或 ModelScope 下载到该目录(带实时进度条),页面同时给出手动git clone命令作备选;已在磁盘上的模型会标记为可用;Device——推理后端(Auto、CPU、CUDA、Vulkan、Metal),选项由服务器上报;Access Token——端点的访问令牌,骰子按钮一键生成;Save保存卡片(改动在此之前只是本地草稿),Start Server/Stop Server控制进程启停。卡片标题的状态图标反映可达性与模型状态(已加载 / 加载中 / 出错)。
CUDA 争用提醒:本机已有其他 CUDA 推理程序占用显卡时(例如用 llama.cpp 跑本地模型),再让 vterm-voice 用
CUDA推理可能导致双方都显著变慢。此时建议把Device设为CPU——这些小型 ASR 模型在 CPU 上运行已经足够快。
提供商与测试
提供商下拉列出 ASR 外挂——内置的 vibe-voice 外挂就指向这个被守护的本地服务器,选中它即可使用本地模型。
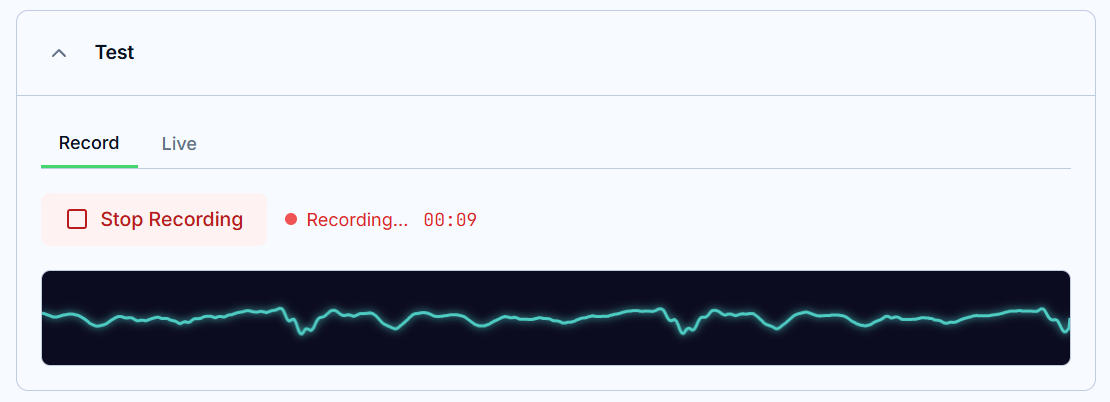
Test 区域无需客户端即可体验:Record(麦克风 → 波形 → 转写)与 Live(流式识别),均带耗时与复制按钮。