เอกสาร
การตั้งค่าเซิร์ฟเวอร์
การป้อนข้อมูลด้วยเสียงเปลี่ยนคำพูดเป็นอินพุตเทอร์มินัล: พูดแทนการพิมพ์ พร้อมขัดเกลา LLM ของถอดความก่อนส่ง (ไม่บังคับ) การจำแนกทำงานเป็นเซิร์ฟเวอร์ ASR ท้องถิ่นด้วยโมเดลบนอุปกรณ์ — เสียงและข้อความอยู่บนเครื่องคุณ หน้านี้ครอบคลุมฝั่งเซิร์ฟเวอร์; ประสบการณ์เดสก์ท็อปอยู่ใน การใช้งานไคลเอนต์
การ์ด Local ASR Server
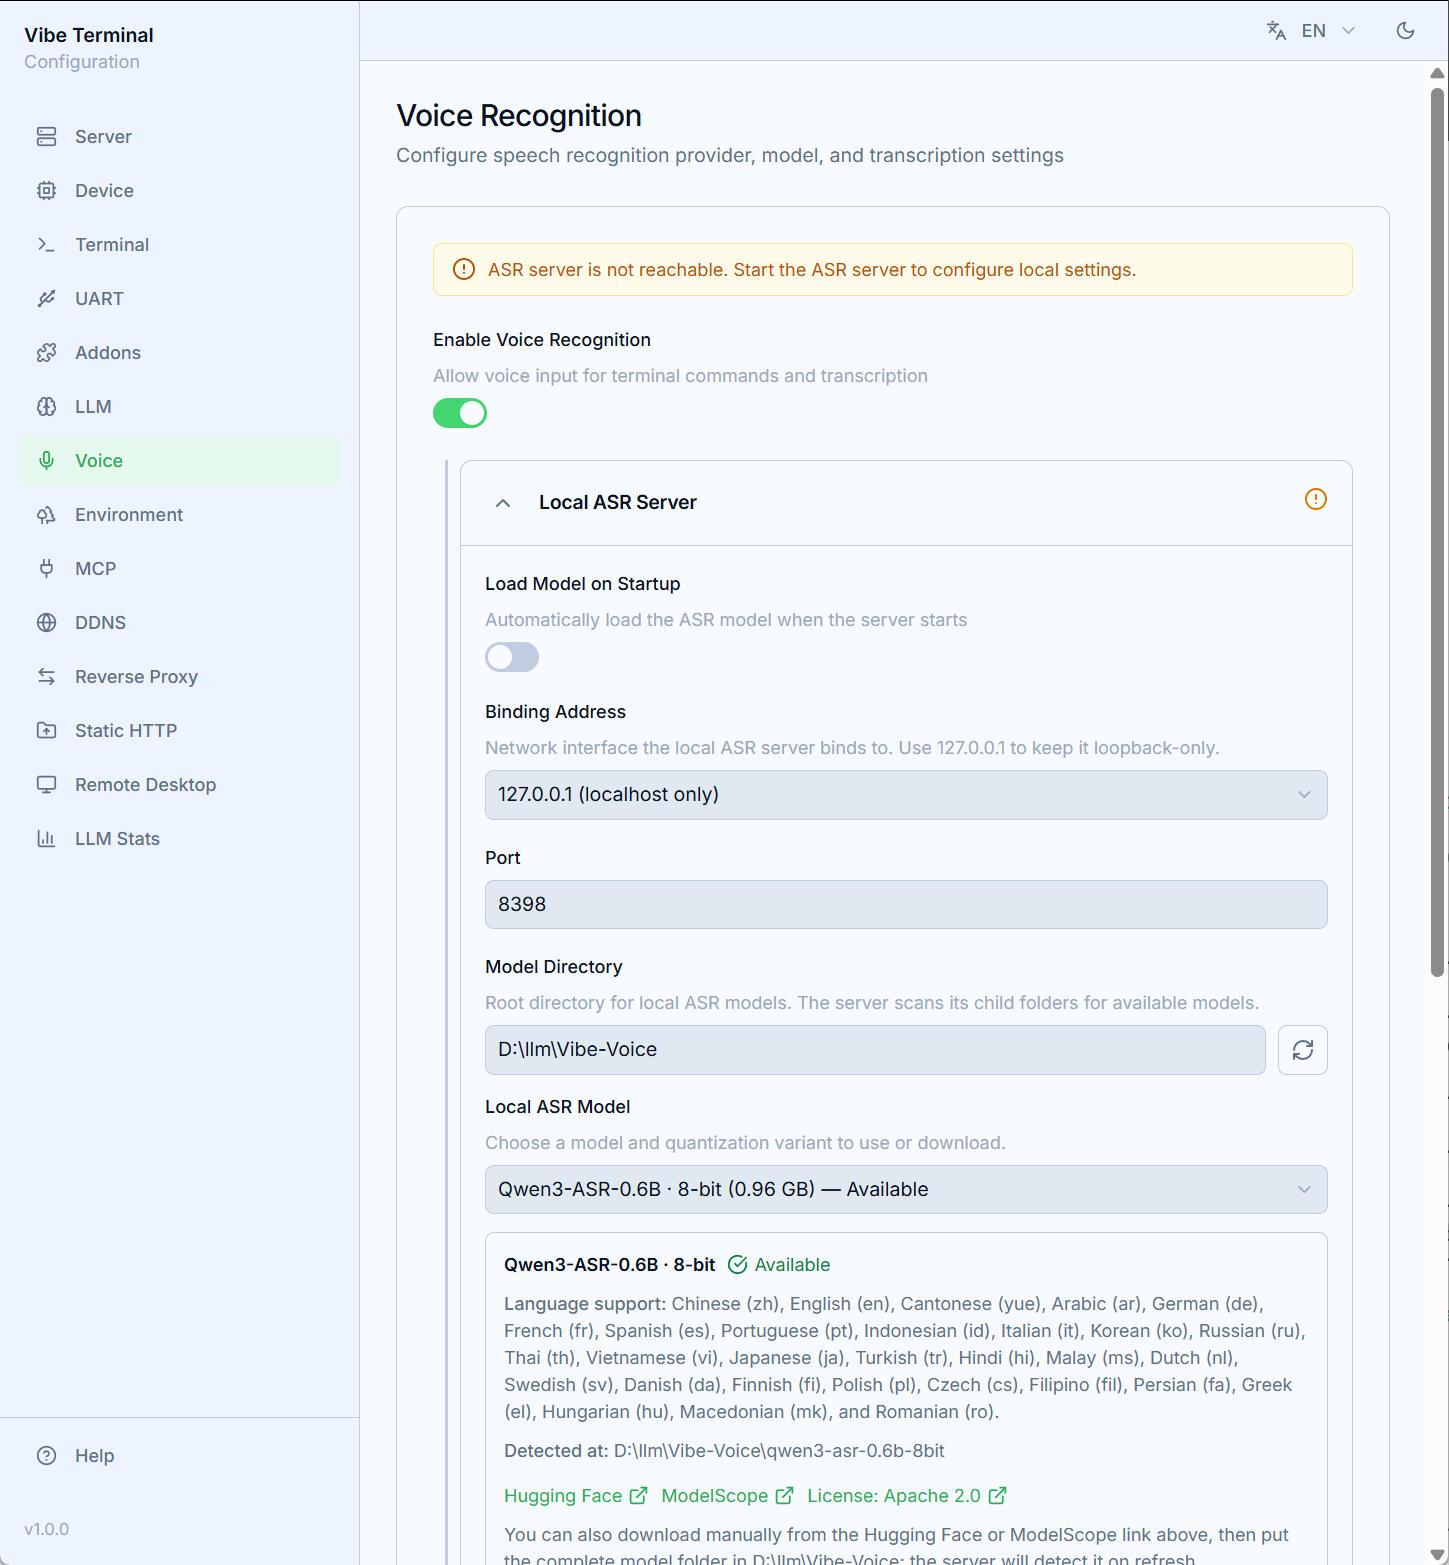
เปิดส่วน Voice ของ Web UI และเปิดการจำแนกเสียง การ์ด Local ASR Server จัดการโพรเซส vterm-voice ที่ถูกคุม:
Load on Startup— เริ่มเซิร์ฟเวอร์ ASR พร้อมแบ็กเอนด์;Bind Address(127.0.0.1เฉพาะ localhost /0.0.0.0ทุกอินเทอร์เฟซ) และPort(ค่าเริ่มต้น8398) — ที่ endpoint ASR รอรับ;Model Directory+Local Model— เลือกจากแค็ตตาล็อกในตัว: ตระกูล Qwen3-ASR, Fun-ASR และ Parakeet แต่ละตัวมีแบบ full / 8-bit / 4-bitDownloadดึงโมเดลจาก Hugging Face หรือ ModelScope เข้าไดเรกทอรีพร้อมแถบความคืบหน้าสด; คำสั่งgit cloneมือแสดงเป็นทางเลือก และโมเดลที่อยู่บนดิสก์ถูกทำเครื่องหมายว่าพร้อม;Device— แบ็กเอนด์อนุมาน (Auto,CPU,CUDA,Vulkan,Metal) ตามที่เซิร์ฟเวอร์รายงาน;Access Token— ความลับร่วมของ endpoint; ปุ่มลูกเต๋าสร้างได้;Saveบันทึกการ์ด (การแก้ไขเป็นร่างท้องถิ่นจนกว่าจะกด) และStart Server/Stop Serverควบคุมโพรเซส ไอคอนสถานะในชื่อการ์ดสะท้อนความพร้อมและสถานะโมเดล (โหลดแล้ว / กำลังโหลด / ผิดพลาด)
การแย่ง CUDA: เมื่อโปรแกรมอนุมาน CUDA ตัวอื่นยึด GPU อยู่แล้ว (เช่น llama.cpp รันโมเดลท้องถิ่น) การให้ vterm-voice ใช้
CUDAด้วยอาจทำให้ทั้งคู่ช้าลงมาก ในกรณีนั้นตั้งDeviceเป็นCPU— โมเดล ASR กะทัดรัดเหล่านี้เร็วพอบน CPU
ผู้ให้บริการและการทดสอบ
ดรอปดาวน์ผู้ให้บริการราย addon ASR — addon vibe-voice ในตัวชี้มาที่เซิร์ฟเวอร์คุมนี้ การเลือกมันคือวิธีให้แผงใช้โมเดลท้องถิ่นของคุณ
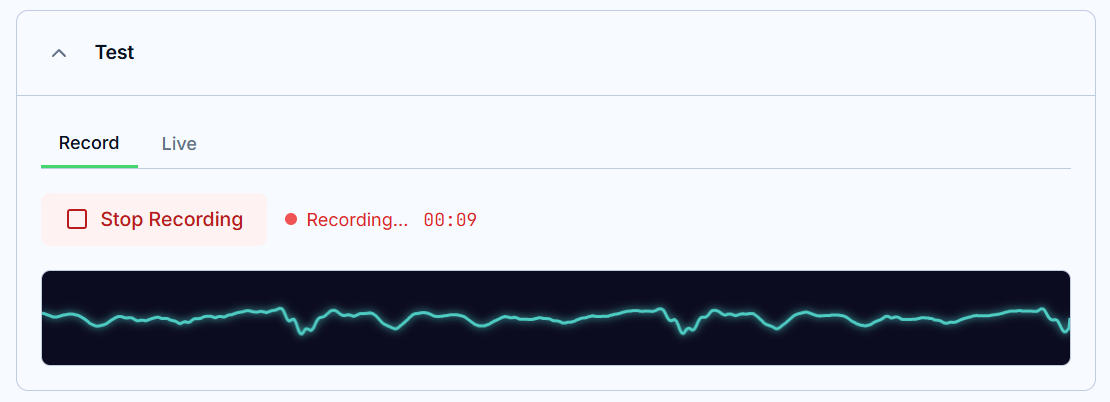
พื้นที่ Test ลองทุกอย่างโดยไม่ต้องมีไคลเอนต์: Record (ไมค์ → รูปคลื่น → ถอดความ) และ Live (จำแนกแบบสตรีม) แต่ละอันมีเวลาและปุ่มคัดลอก