文件
伺服器設定
語音輸入把說話變成終端機輸入:動口不動手,還可在送出前用 LLM 潤色轉寫文字。辨識由本地 ASR 伺服器與本地模型完成——音訊和文字都不離開你的機器。本頁講伺服器設定;桌面端體驗見「用戶端使用」。
Local ASR Server 卡片
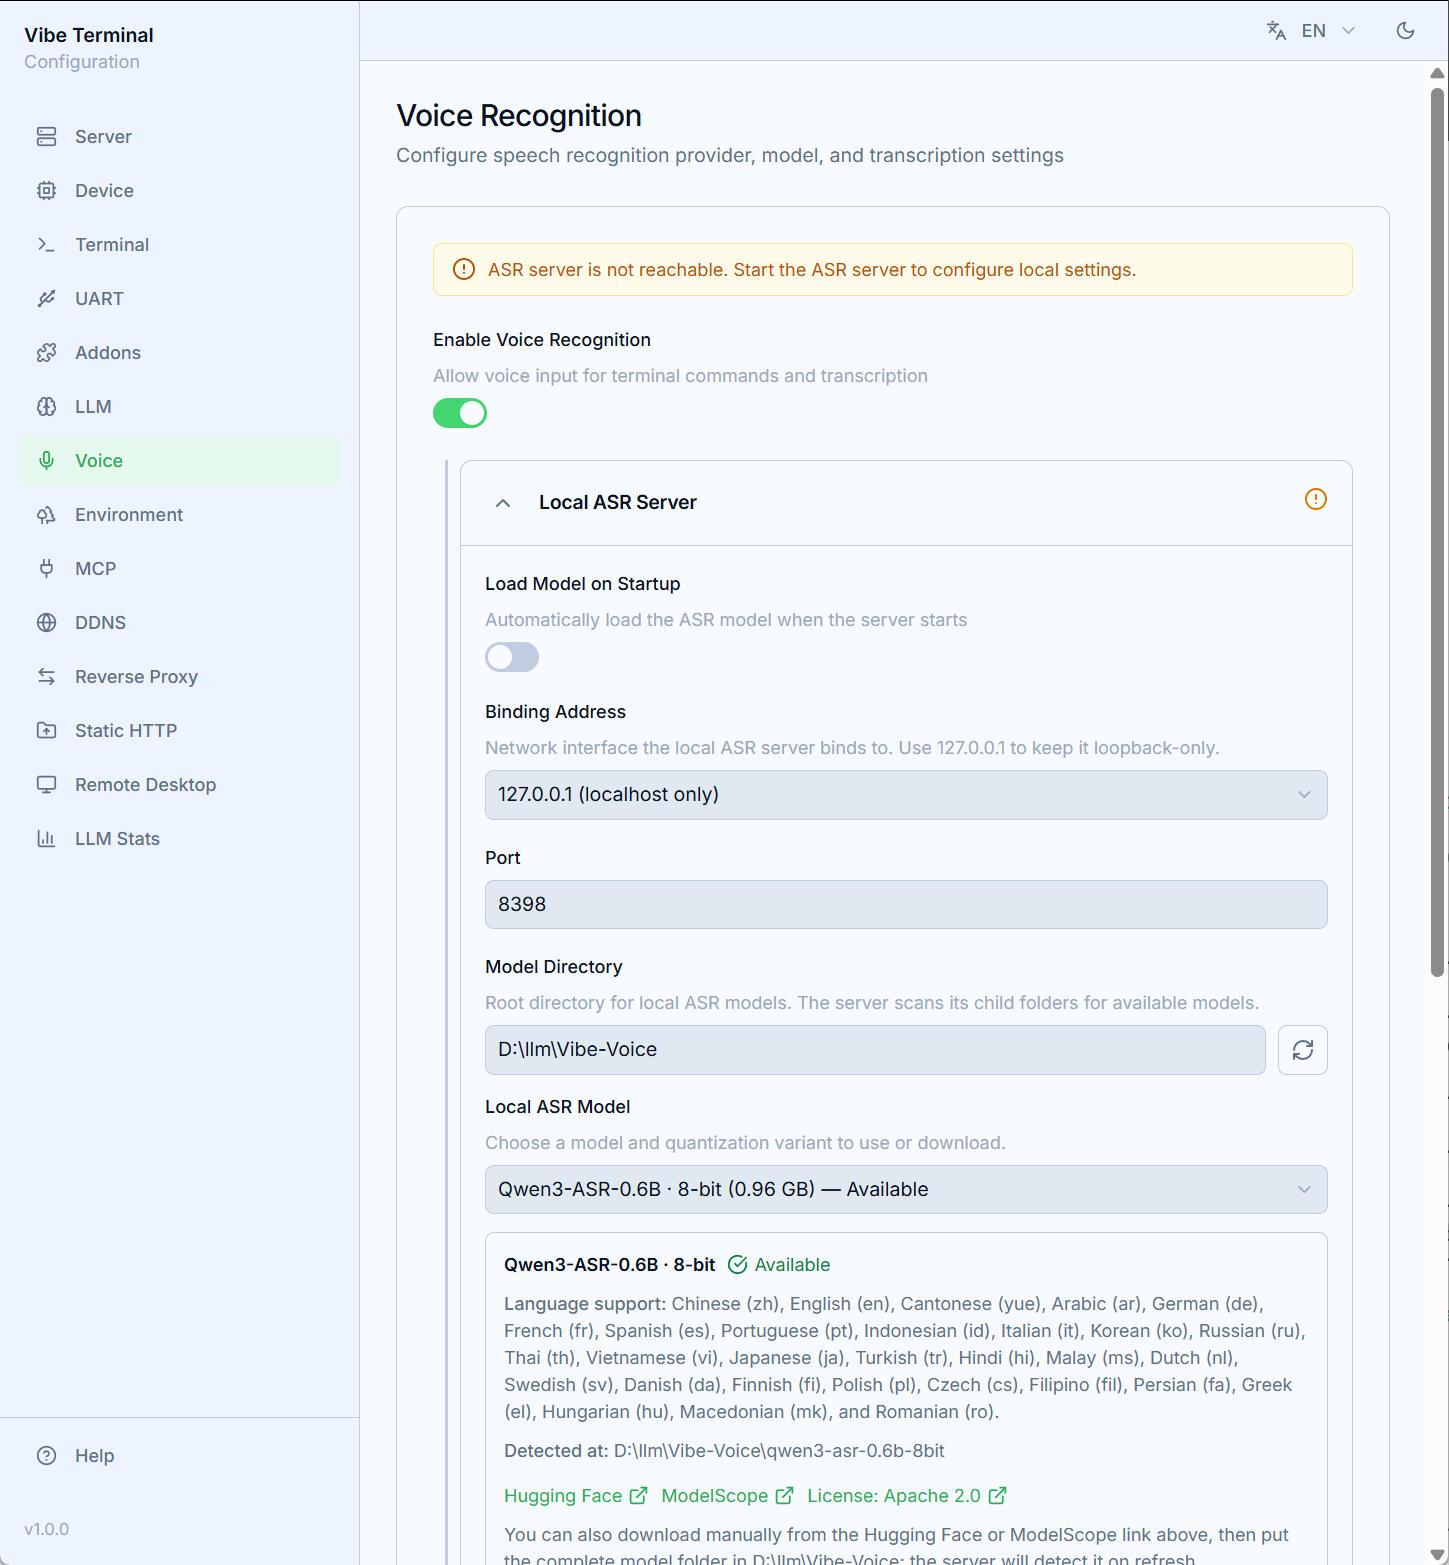
開啟 Web 介面的 Voice 頁並啟用語音辨識。Local ASR Server 卡片管理受守護的 vterm-voice 程序:
Load on Startup——隨後端一起啟動 ASR 伺服器;Bind Address(127.0.0.1僅本機 /0.0.0.0所有網卡)與Port(預設8398)——ASR 端點的監聽位址;Model Directory+Local Model——從內建目錄選模型:Qwen3-ASR、Fun-ASR、Parakeet 三個家族,各有完整 / 8-bit / 4-bit 版本;Download從 Hugging Face 或 ModelScope 下載到該目錄(帶即時進度條),頁面同時提供手動git clone指令作備選;已在磁碟上的模型會標記為可用;Device——推理後端(Auto、CPU、CUDA、Vulkan、Metal),選項由伺服器回報;Access Token——端點的存取權杖,骰子按鈕一鍵產生;Save儲存卡片(改動在此之前只是本地草稿),Start Server/Stop Server控制程序啟停。卡片標題的狀態圖示反映可達性與模型狀態(已載入 / 載入中 / 錯誤)。
CUDA 競用提醒:本機已有其他 CUDA 推理程式佔用顯示卡時(例如用 llama.cpp 跑本地模型),再讓 vterm-voice 用
CUDA推理可能導致雙方都明顯變慢。此時建議把Device設為CPU——這些小型 ASR 模型在 CPU 上執行已經夠快。
提供商與測試
提供商下拉列出 ASR 外掛——內建的 vibe-voice 外掛就指向這個受守護的本機伺服器,選它即可使用本地模型。
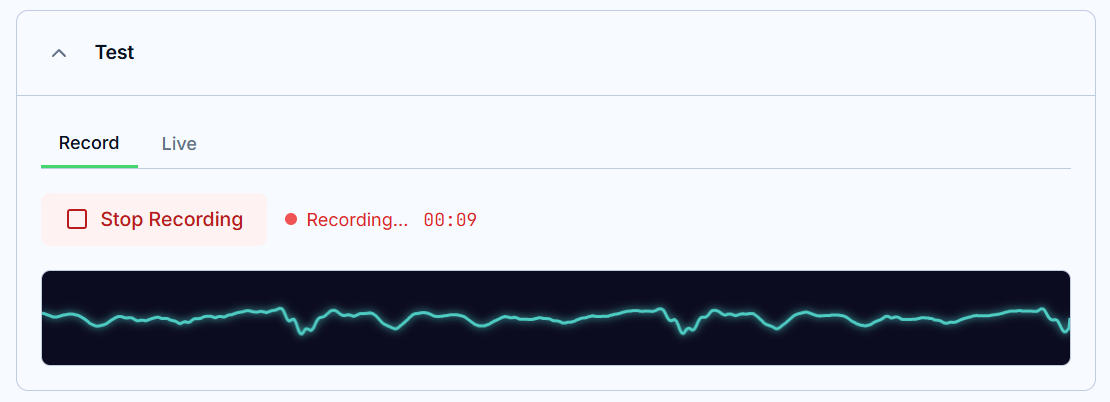
Test 區域無需用戶端即可體驗:Record(麥克風 → 波形 → 轉寫)與 Live(串流辨識),均附耗時與複製按鈕。